Trouver des emails en masse : ce que fait vraiment un outil, étape par étape
Trouver des emails en masse, c'est partir d'une liste de personnes et récupérer leurs adresses professionnelles en une seule passe, au lieu d'une recherche à la fois. Tous les outils de la catégorie enchaînent les mêmes quatre étapes, et savoir laquelle échoue fait la différence entre changer de fournisseur et réparer son fichier.
- Il résout l'entreprise vers un domaine. À partir d'un nom d'entreprise, il doit décider à quel domaine ce nom correspond. Cette étape est invisible, et c'est là que naissent la plupart des erreurs silencieuses.
- Il déduit le format d'adresse. La plupart des entreprises utilisent un seul format dans toute l'organisation, et l'outil le déduit des adresses qu'il a déjà observées sur ce domaine.
- Il construit l'adresse candidate et la teste. Prénom, nom et format produisent une adresse, qui est ensuite confrontée au serveur de messagerie destinataire.
- Il rend un verdict par ligne. Trouvée et vérifiée, trouvée mais invérifiable, ou rien. C'est cette troisième catégorie que personne n'anticipe.
Presque toutes les comparaisons du domaine classent les outils sur la quatrième étape. Cette page parle de la première et de la deuxième, parce que c'est là que se joue votre taux de correspondance, et parce que c'est la seule partie que vous contrôlez. Plus bas, vous pouvez télécharger un vrai export Derrick : 37 éditeurs et intégrateurs de logiciels B2B français, avec le nom de l'entreprise, le domaine, le site, la page LinkedIn, le secteur, la ville, la région, la tranche d'effectif et l'année de création, et aucun email ni téléphone dedans. C'est un vrai export et non une illustration nettoyée, aspérités comprises, et c'est justement l'intérêt : voilà ce que rend réellement cette étape. Pour la version un prospect à la fois, notre guide sur la recherche d'email d'un lead traite la recherche unitaire ; cette page traite le lot. Les deux vivent dans le cluster email finder.
Votre fichier d'entrée décide du taux de correspondance, pas votre fournisseur
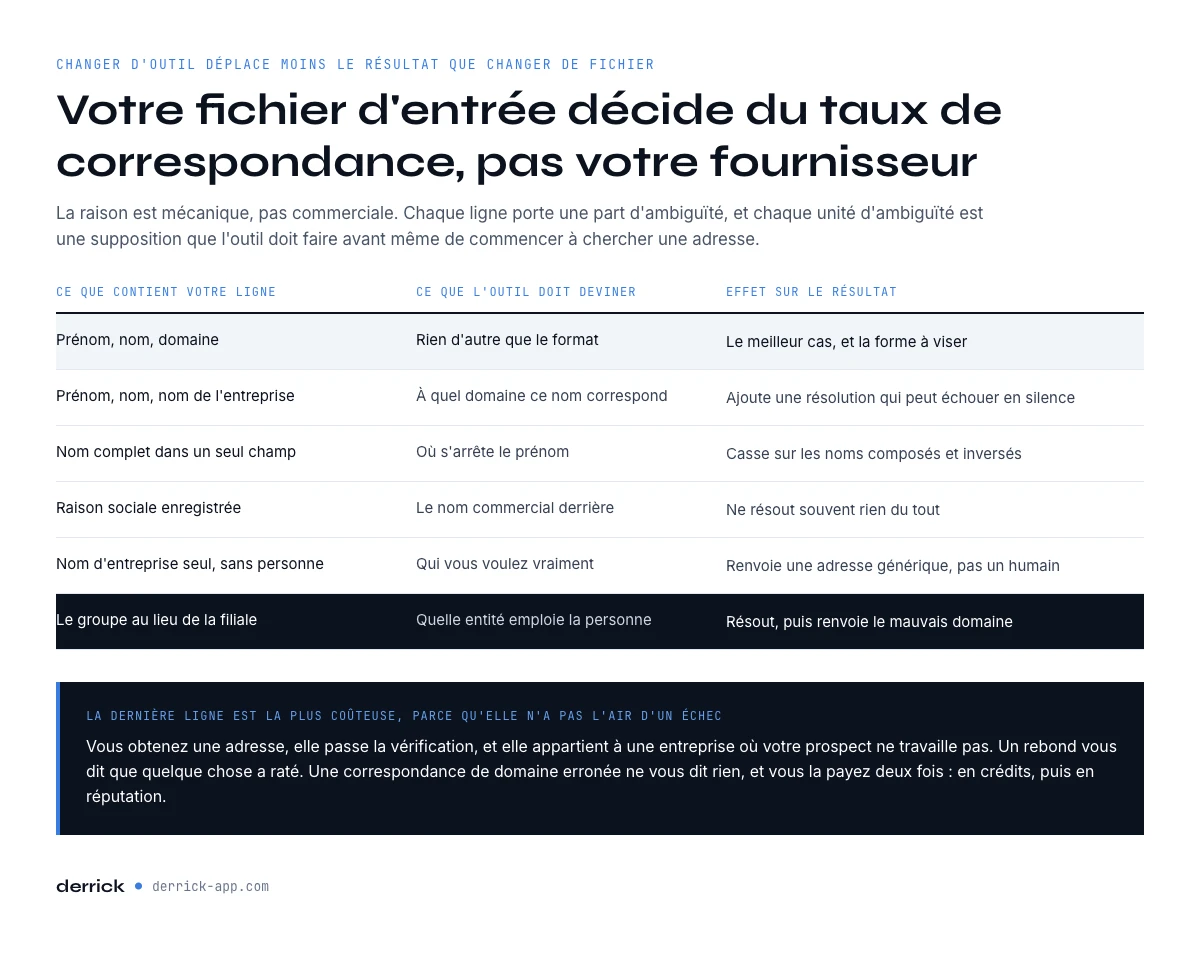
Faites la comparaison chez vous et le même écart reviendra : changer d'outil déplace moins le résultat que changer la forme du fichier. La raison est mécanique, pas commerciale. Chaque ligne que vous confiez porte une certaine dose d'ambiguïté, et chaque unité d'ambiguïté est une supposition que l'outil doit faire avant même de commencer à chercher une adresse.
| Ce que contient votre ligne | Ce que l'outil doit deviner | Effet sur le résultat |
|---|---|---|
| Prénom, nom, domaine | Rien, sauf le format d'adresse | Le meilleur cas, et la forme à viser |
| Prénom, nom, nom d'entreprise | À quel domaine ce nom correspond | Ajoute une étape de résolution qui peut échouer en silence |
| Nom complet dans un seul champ | Où s'arrête le prénom | Casse sur les noms composés et inversés |
| Raison sociale | Le nom commercial derrière | Ne résout souvent rien du tout |
| Nom d'entreprise seul, sans personne | Qui vous voulez réellement | Renvoie une adresse générique, pas un humain |
| Groupe au lieu de la filiale | Quelle entité emploie la personne | Résout, puis renvoie le mauvais domaine |
La dernière ligne est la plus coûteuse, parce qu'elle n'a pas l'air d'un échec. Vous obtenez une adresse, elle passe la vérification, et elle appartient à une entreprise où votre prospect ne travaille pas. Un rebond vous dit que quelque chose a raté. Une correspondance sur le mauvais domaine ne vous dit rien, et vous la payez deux fois : une fois en crédits, une fois en réputation.
Résolvez le domaine avant de lancer quoi que ce soit
Si votre liste contient des noms d'entreprise plutôt que des domaines, traitez la résolution comme un travail à part, avec son propre contrôle qualité, et non comme une étape fondue invisiblement dans la recherche d'adresses. Lancez-la, puis regardez ce qui revient avant de dépenser le moindre crédit sur des adresses.
Trois contrôles attrapent l'essentiel des dégâts, et ils prennent quelques minutes sur un échantillon.
- Triez par domaine et cherchez les doublons. Deux entreprises sans rapport qui pointent vers le même domaine, c'est que le rapprochement s'est rabattu sur un nom voisin. Ça arrive surtout sur les noms courts et sur tout ce qui contient un mot commun.
- Comparez d'un coup d'œil le domaine et le nom sur 30 lignes. Les cas groupe contre filiale sautent immédiatement, et ils sont en général concentrés sur un segment de la liste plutôt que répartis uniformément.
- Vérifiez le pays. La filiale française d'un groupe américain a souvent son propre domaine et son propre format d'adresse. Résoudre vers la maison mère donne une adresse valide, mais au mauvais bureau.
La liste téléchargeable sur cette page est la sortie exacte de cette étape : chaque entreprise figure à côté de son domaine résolu, ce qui rend visibles d'un seul regard les paires manifestement justes et celles qui mériteraient un second regard. Notre guide sur retrouver une entreprise à partir d'un email traite le même problème dans l'autre sens, et ce que rend un email scraper couvre le cas d'une liste récoltée plutôt que construite.
Ce qu'un outil de recherche d'emails en masse ne peut pas faire
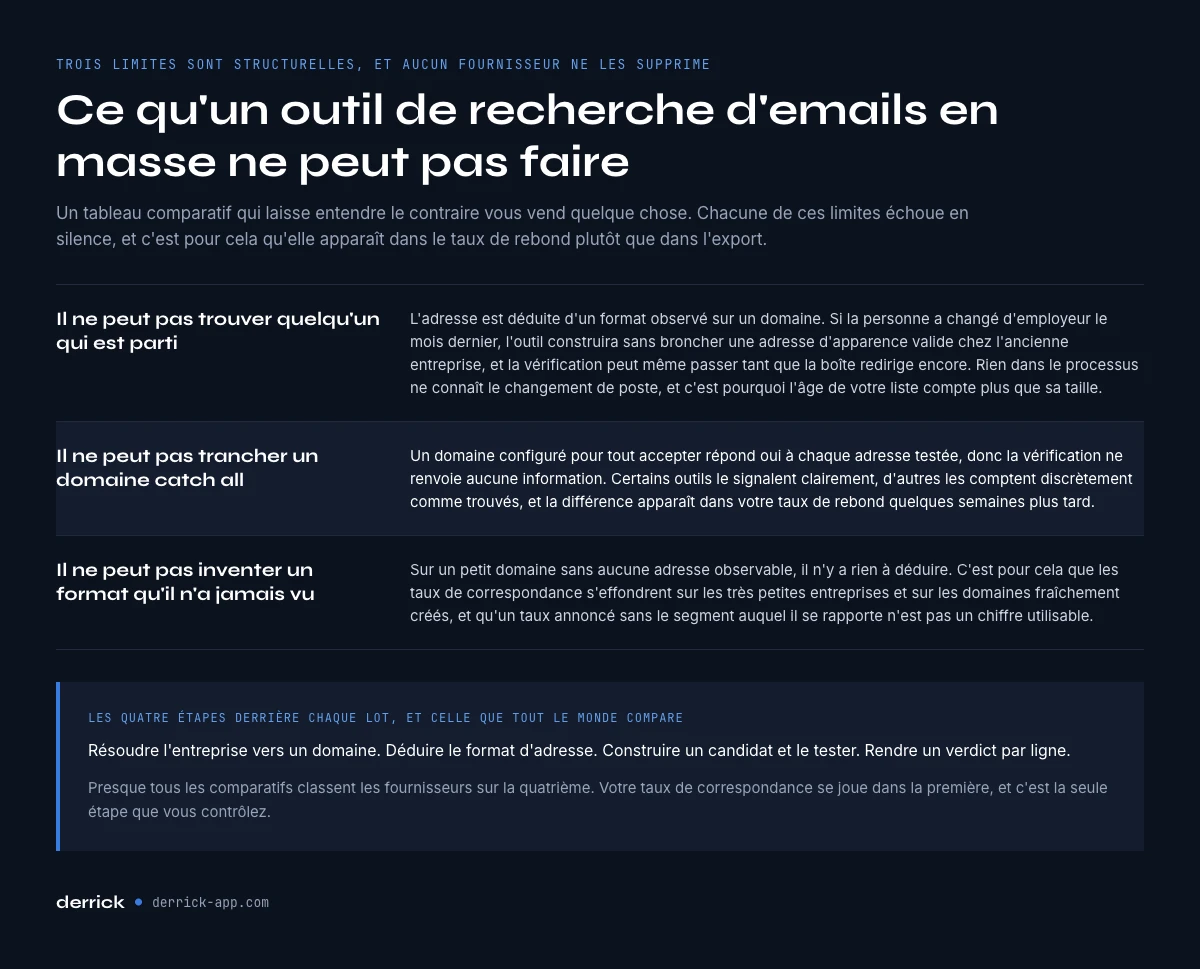
Trois limites sont structurelles. Aucun fournisseur ne les lève, et un tableau comparatif qui laisse croire le contraire vous vend quelque chose.
Il ne peut pas trouver quelqu'un qui est parti. L'adresse est déduite d'un format sur un domaine. Si la personne a changé d'employeur le mois dernier, l'outil construira sans hésiter une adresse d'apparence valide dans l'ancienne entreprise, et la vérification peut même passer tant que la boîte est encore redirigée. Rien dans le processus ne connaît le changement de poste. C'est pour ça que l'âge de la liste compte plus que sa taille.
Il ne peut pas trancher un domaine catch-all. Un domaine configuré pour tout accepter répond oui à chaque adresse testée, donc la vérification ne rapporte aucune information. Certains outils les signalent clairement, d'autres les comptent discrètement comme trouvées, et l'écart se voit dans votre taux de rebond des semaines plus tard, pas dans l'export.
Il ne peut pas inventer un format qu'il n'a jamais vu. Sur un petit domaine sans adresse observable, il n'y a rien à déduire. C'est pour ça que les taux de correspondance s'effondrent sur les très petites structures et sur les domaines récents, et pourquoi un taux annoncé sans le segment auquel il se rapporte n'est pas un chiffre exploitable.
À la ligne ou au résultat : la facturation qui décide de votre coût réel
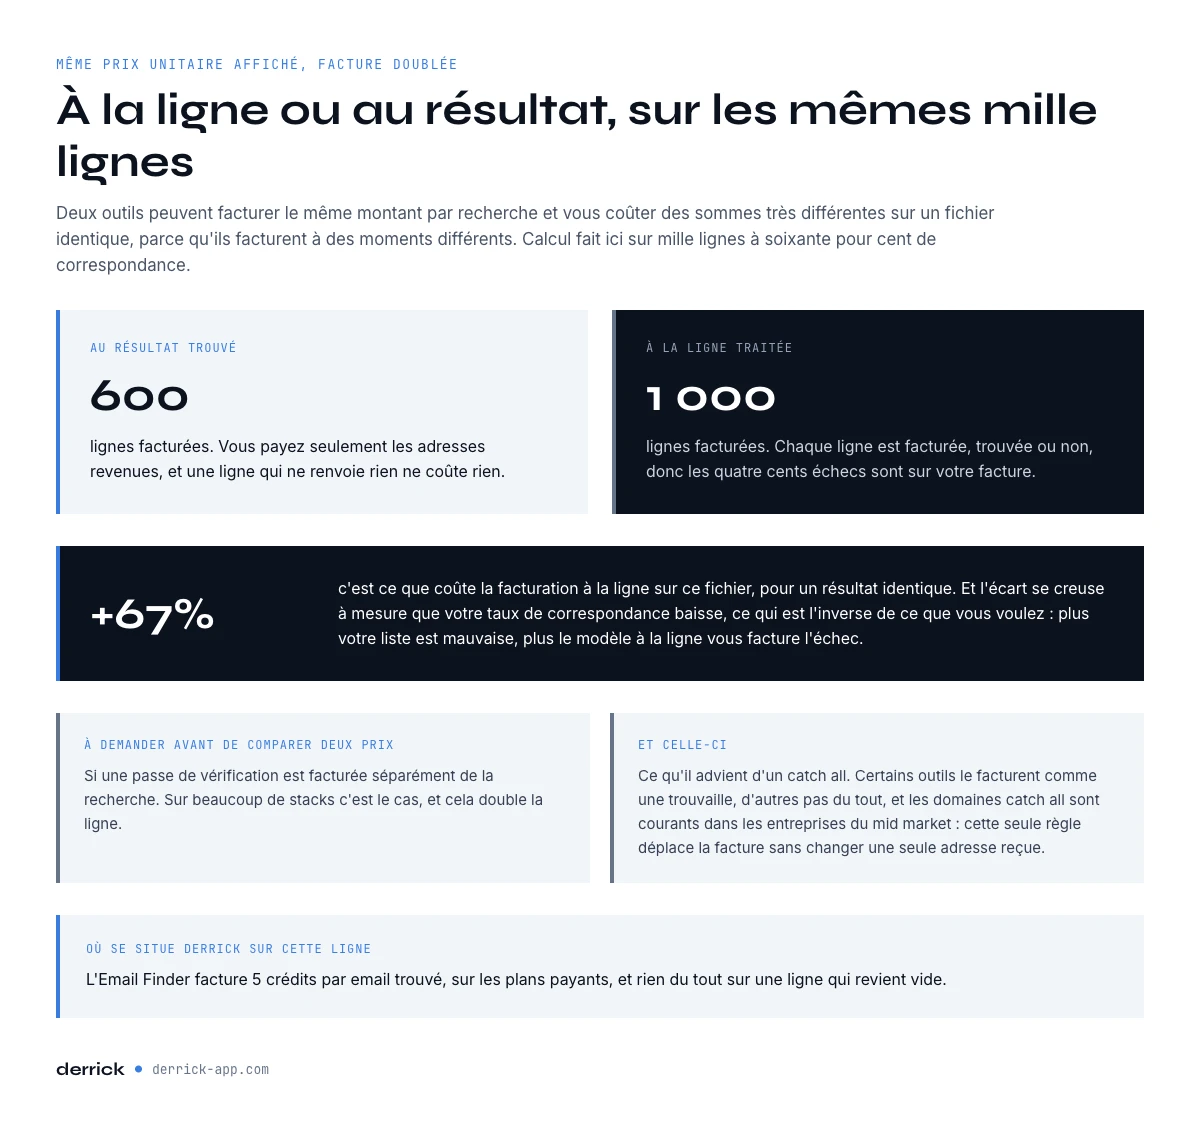
Deux outils peuvent afficher le même prix unitaire et vous coûter le double sur le même fichier, parce qu'ils facturent à des moments différents.
| Mode de facturation | Ce que vous payez | Sur 1000 lignes à 60 % de correspondance |
|---|---|---|
| Au résultat trouvé | Uniquement les lignes qui ont rendu une adresse | Vous payez 600 |
| À la ligne traitée | Chaque ligne, trouvée ou non | Vous payez 1000 |
Sur ce fichier, la facturation à la ligne coûte 67 % de plus que la facturation au résultat, pour un résultat identique. L'écart se creuse à mesure que le taux de correspondance baisse, soit l'inverse de ce que vous voulez : moins votre liste donne de résultats, plus le modèle à la ligne vous facture l'échec. Derrick facture Email Finder à 5 crédits par email trouvé, et rien du tout sur une ligne qui revient vide. Calculez ce que coûterait votre propre fichier.
Deux points à vérifier avant de comparer deux prix. Demandez si la vérification est facturée à part de la recherche, parce que dans beaucoup de configurations elle l'est, et elle double la ligne. Et demandez ce qui arrive à un catch-all : certains outils le comptent comme une trouvaille, d'autres comme rien, et comme les domaines catch-all sont fréquents chez les entreprises de taille intermédiaire, cette seule règle peut déplacer la facture d'une telle liste sans changer une seule adresse reçue.
Quoi faire des lignes revenues vides
Chaque lot renvoie un ensemble de lignes sans adresse, et la plupart des équipes le suppriment. C'est une erreur pour deux raisons. Cet ensemble n'a rien d'aléatoire, donc il porte une information sur votre fichier. Et c'est là qu'atterrissent vos comptes nommés, parce qu'une grande entreprise au format d'adresse inhabituel échoue pour la même raison qu'une petite.
Triez les vides avant de décider quoi que ce soit. Ils se répartissent en quatre groupes qui appellent quatre gestes différents.
- Mauvaise entrée. Le nom tenait dans un seul champ, le nom d'entreprise était la raison sociale, le domaine a mal résolu. Corrigez la ligne et relancez-la. Ce groupe est souvent le plus gros, et son diagnostic ne coûte rien.
- Domaine réellement petit. Rien à déduire, et relancer le mois prochain n'y changera rien. Orientez ces lignes vers un autre canal plutôt que vers une nouvelle tentative.
- La personne n'est plus là. L'entreprise résout, le format est connu, l'individu est parti. Relancez la personne, pas la ligne : trouvez où elle travaille maintenant, puis cherchez l'adresse là-bas.
- Compte à forte valeur, aucune adresse. Une cible nommée que vous ne pouvez pas joindre par email n'est pas une ligne ratée, c'est un appel ou un message LinkedIn. Notre guide sur les adresses email de dirigeants couvre les routes manuelles qui valent le temps qu'on y passe sur ce groupe.
La discipline qui compte : ne relancez jamais un fichier inchangé en espérant une autre réponse. Si rien n'a bougé en entrée, rien ne bougera en sortie, et sur une facturation à la ligne vous payez plein tarif pour l'apprendre deux fois.
Où tourne le lot, et pourquoi ça décide plus qu'il n'y paraît
Presque tous les outils de la catégorie supposent la même forme : vous exportez un CSV, vous le déposez dans une application web, vous attendez, vous téléchargez un autre CSV, vous le réintégrez là où la liste vit réellement. Cet aller-retour est invisible dans un comparatif de fonctionnalités, et c'est là que se cache le coût opérationnel.
Chaque passage crée une copie de votre liste. Les copies divergent, quelqu'un travaille depuis la mauvaise, et la réintégration est manuelle à chaque fois. Passez la même liste toutes les semaines et vous ne tenez pas un workflow, vous entretenez quatre fichiers.
L'alternative est de laisser la liste où elle est et d'y amener la recherche. Derrick fait tourner le même enrichissement sur trois surfaces, avec les mêmes crédits : la sidebar Google Sheets, où les adresses se remplissent à côté des lignes auxquelles elles appartiennent ; un assistant IA via MCP, où vous demandez en langage courant et récupérez le lot dans la conversation ; et l'API REST, quand la liste vit dans un CRM ou dans un pipeline plutôt que dans un fichier. Une application web arrive bientôt pour les équipes qui préfèrent travailler hors d'un tableur. Le bloc de démonstration de cette page fait tourner la même recherche sur chacune des trois surfaces, pour que l'écart entre elles se voie au lieu de se raconter.
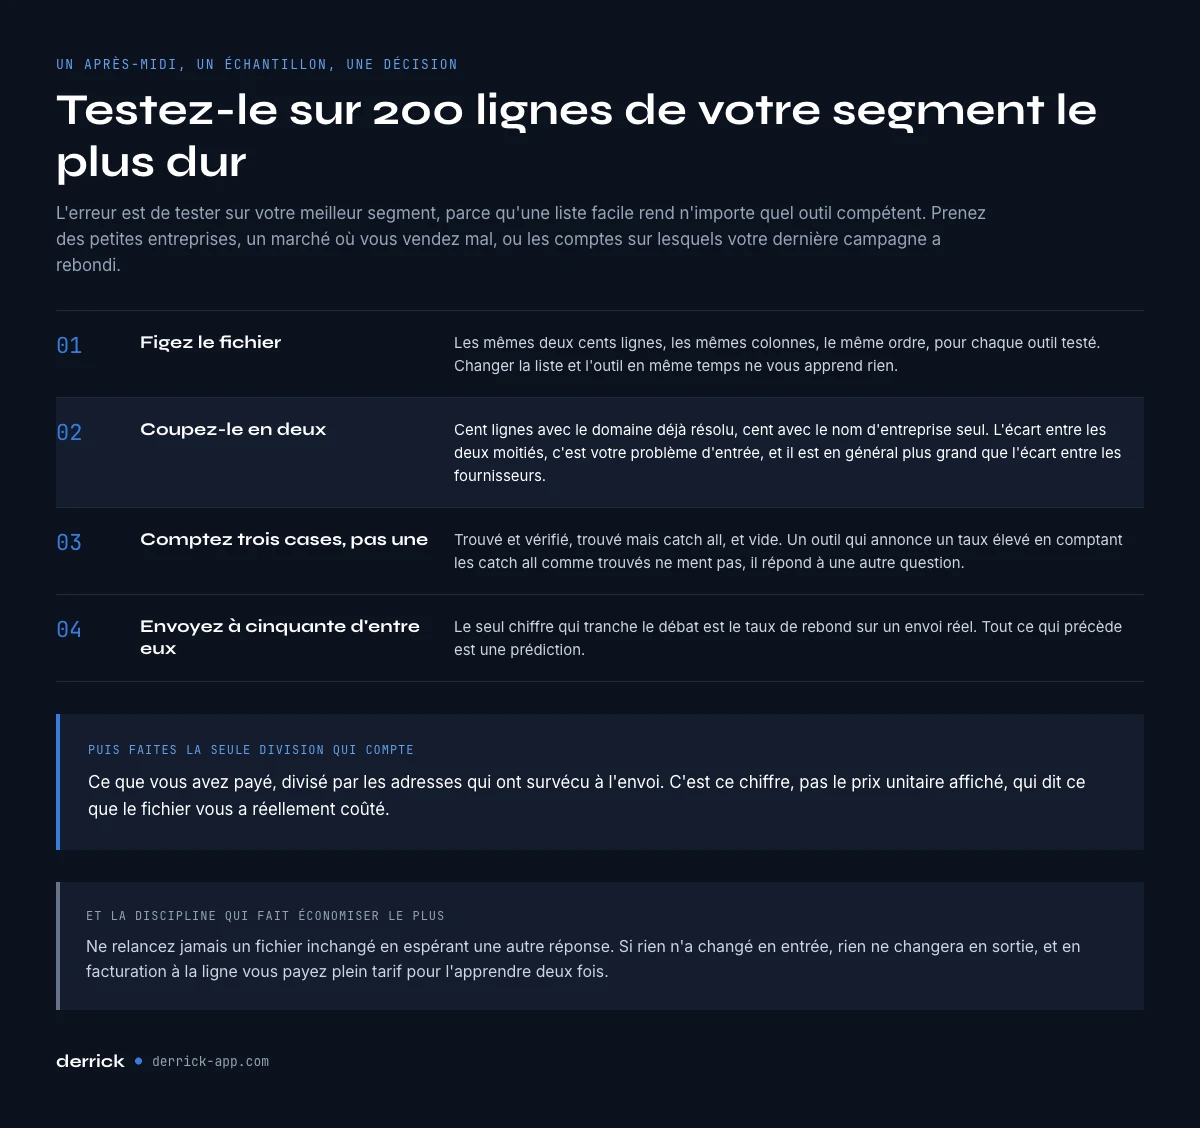
Comment tester un outil pour trouver des emails en masse, sur 200 lignes
Un essai qui produit une décision tient en un après-midi et un échantillon. L'erreur est de tester sur son meilleur segment, parce qu'une liste facile fait paraître tous les outils compétents.
- Prenez 200 lignes de votre segment le plus dur. Des petites structures, un marché où vous vendez mal, ou les comptes sur lesquels votre dernière campagne a rebondi.
- Figez le fichier. Les mêmes 200 lignes, les mêmes colonnes, le même ordre, pour chaque outil testé. Changer la liste et l'outil en même temps n'apprend rien.
- Coupez-le en deux. Cent lignes avec le domaine résolu, cent avec le nom d'entreprise seul. L'écart entre les deux, c'est votre problème d'entrée, et il est en général plus grand que l'écart entre fournisseurs.
- Comptez trois catégories, pas une. Trouvée et vérifiée, trouvée mais catch-all, et vide. Un outil qui affiche un taux élevé en comptant les catch-all comme trouvés ne ment pas, il répond à une autre question.
- Envoyez à 50 d'entre elles. Le seul chiffre qui tranche est le taux de rebond sur un vrai envoi. Tout ce qui vient avant est une prédiction.
Divisez ensuite ce que vous avez payé par les adresses qui ont survécu à l'envoi. C'est ce chiffre, et pas le prix unitaire affiché, qui dit ce que le fichier vous a réellement coûté. Notre guide du vérificateur de rebonds couvre la passe de vérification qui s'intercale entre l'étape quatre et l'étape cinq.
Trouver des emails en masse : ce qu'il faut retenir
- Quatre étapes tournent derrière chaque lot, et seule la dernière est comparée. Le taux de correspondance se joue dans la première.
- Prénom, nom et domaine : c'est la forme d'entrée à viser. Prénom, nom et nom d'entreprise ajoute une résolution qui échoue en silence.
- Une correspondance sur le mauvais domaine coûte plus cher qu'un rebond, parce que rien ne vous signale qu'elle a eu lieu.
- La facturation à la ligne coûte plus cher qu'au résultat, et l'écart grandit quand le taux de correspondance baisse.
- Les lignes vides sont quatre problèmes différents. Triez-les avant de relancer, et ne relancez jamais un fichier inchangé.
- Exporter, déposer, télécharger et refusionner est un coût caché. Enrichir là où la liste vit déjà le supprime.
- Testez sur vos 200 lignes les plus dures, comptez les catch-all à part, et jugez sur le taux de rebond d'un vrai envoi.
Derrick trouve et vérifie les adresses sur la liste là où elle vit déjà, avec Email Finder à 5 crédits par email trouvé et Email Verification à 1 crédit par email, tous deux facturés uniquement quand un résultat revient. Les deux vivent sur les plans payants, qui démarrent à 9 euros par mois pour 4000 crédits, et les crédits non consommés sont reportés. L'API REST et le serveur MCP arrivent avec les plans supérieurs, et la page tarifs porte les seuils à jour. Regardez ce que coûte un lot à votre taille, ou parcourez le reste du cluster sur la recherche et la vérification d'adresses.
Nous publions aussi un email tous les 15 jours avec ce que nous mesurons sur la qualité de la donnée de prospection. Abonnez-vous depuis la page d'accueil.
À lire aussi dans ce cocon
 Email Finder
Lead Email Finder : le guide complet pour trouver l'email de vos prospects
Trouver les emails pro de vos prospects depuis nom + entreprise. Les 5 méthodes fiables + benchmarks accuracy.
Lire le guide → Email Finder
Comment Trouver le Nom d'Entreprise à partir d'une Adresse Email : Guide Complet
Reverse-lookup : depuis un email pro vers le nom + site de l'entreprise. Les 4 méthodes comparées accuracy + vitesse.
Lire le guide → Email Finder
Catch-all email : comment les détecter et les gérer en prospection B2B
Catch-all = domaine qui accepte tout email. Pourquoi c'est risqué, comment détecter, quand envoyer quand même.
Lire le guide → Email Finder
Bounce Email Checker : Comment Vérifier vos Emails et Éviter les bounces
Réduire le bounce rate à <2% - les 5 checks avant toute campagne + tactiques warmup.
Lire le guide → Email Finder
Outils Email Finder LinkedIn : le guide pour bien choisir
Les quatre catégories d'outils email finder LinkedIn, les critères qui comptent, et comment choisir selon votre flux.
Lire le guide → Email Finder
API Email Finder
Comment l'API email finder de Derrick renvoie des emails professionnels vérifiés en REST et via MCP, ce que cela coûte, et comment lancer la même recherche à grande échelle.
Lire le guide → Email Finder
Emails de dirigeants : comment les trouver (2026)
Les boîtes des dirigeants suivent les mêmes formats que les autres, mais elles sont filtrées bien plus dur et vérifiées bien moins souvent. Les cinq méthodes qui marchent, l'étape de vérification, et le coût à l'échelle.
Lire le guide → Email Finder
Email scraper : ce qu'il renvoie et pourquoi les listes rebondissent
Scraper contre finder, les quatre sources, pourquoi les listes scrapées rebondissent, et les six contrôles qui rendent un scrape envoyable.
Lire le guide →Lancez votre enrichissement en 30 secondes
Gratuit, 100 crédits/mois. Sans carte bancaire.