Meilleur scraper LinkedIn : 10 outils comparés (prix, limites, données)
Quel est le meilleur scraper LinkedIn en 2026 ? Découvrez 10 outils comparés : données extraites, risque de ban et coût réel par ligne utilisable.
Le meilleur scraper LinkedIn n'est pas le plus complet, c'est celui qui rend les champs dont vous avez besoin, là où vous travaillez déjà, sans faire exploser la facture en heures de nettoyage. Ce comparatif présente dix outils, Derrick en tête, avec les champs qu'ils rendent, l'architecture sur laquelle ils reposent et ce qu'ils coûtent vraiment par ligne utilisable.
Pour la méthodologie complète avant de choisir un outil - APIs vs scrapers vs extensions Chrome, le cadre légal et les questions de workflow qui décident vraiment de votre méthode - commencez par notre guide complet de l’extraction de données LinkedIn, puis revenez à ce comparatif.
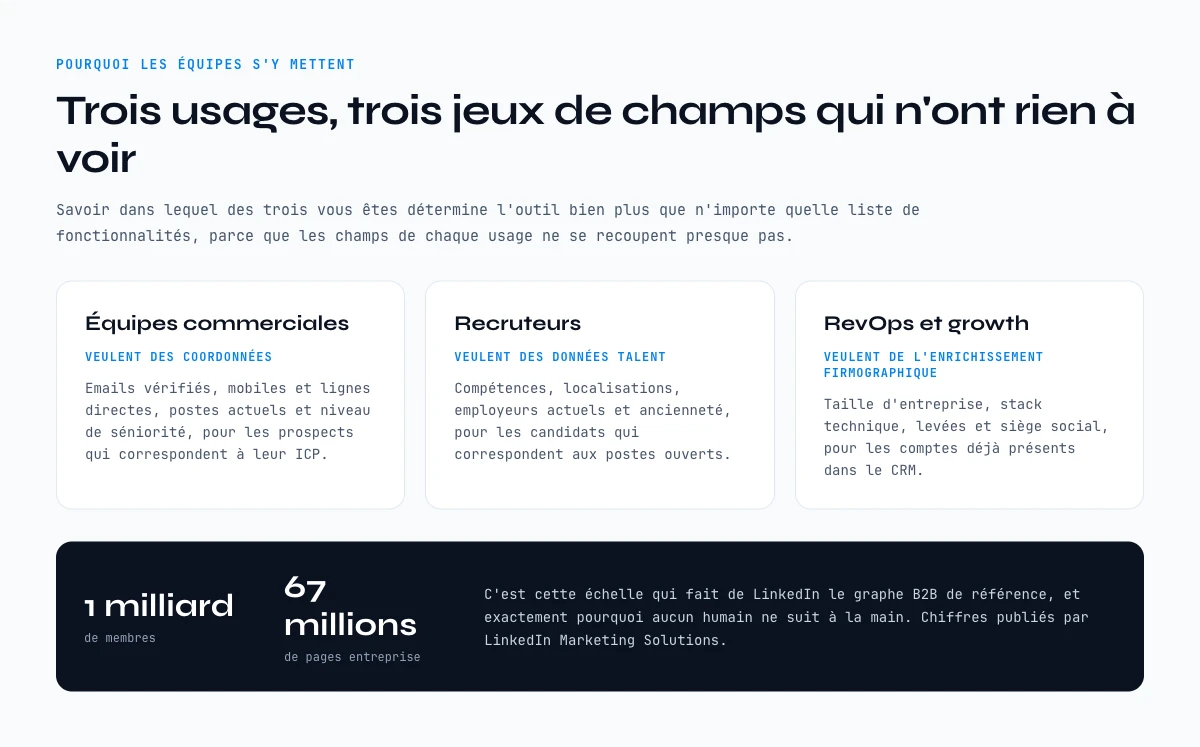
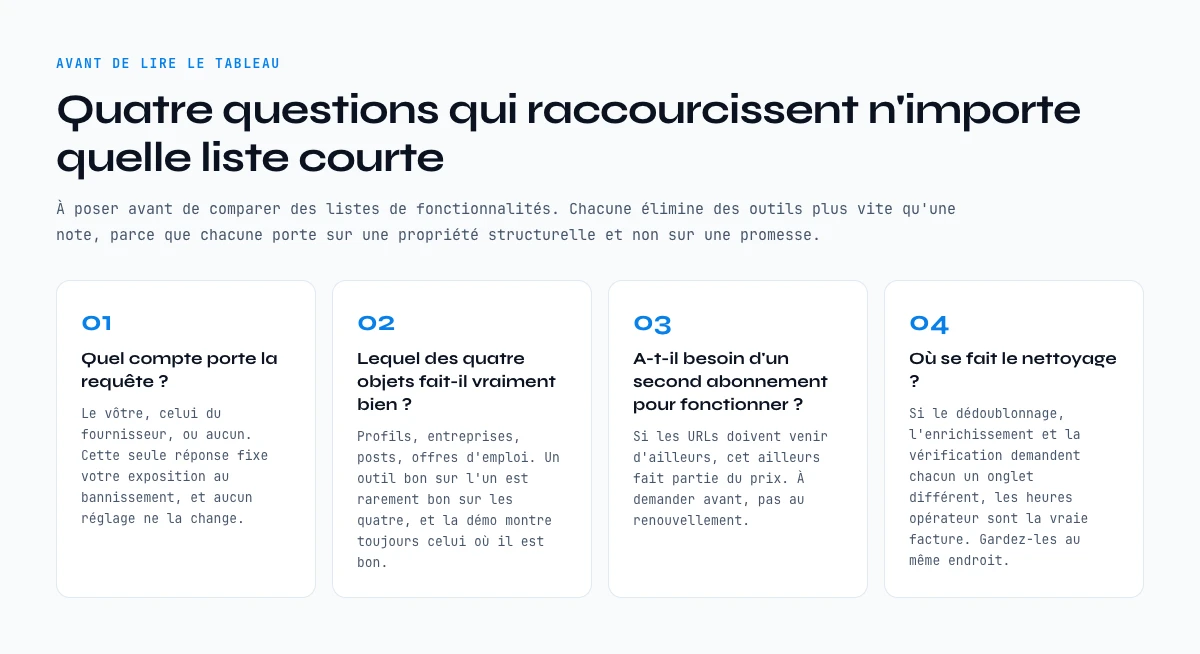
Pourquoi scraper LinkedIn ?
Le scraping de LinkedIn est une méthode de growth hacking qui consiste à extraire les données de prospects de manière automatisée. Il permet entre autres de se constituer une liste de leads ou de prospects très facilement pour le développement de votre entreprise.
Pour récolter de nombreuses informations, il existe des outils de scraping, qui vont entrer directement dans la structure d’un site web afin d’obtenir les informations qu’ils souhaitent.
Scraper LinkedIn vous permettra d’extraire de nombreuses données de vos prospects à des fins de prospection, beaucoup plus efficaces et personnalisées. Vous pouvez vous constituer des bases de données, des fichiers de contacts, chercher des partenaires tout en faisant grandir votre réseau. Nous allons nous intéresser aux outils de scraping juste après.
Ce que le meilleur scraper LinkedIn extrait vraiment, champ par champ
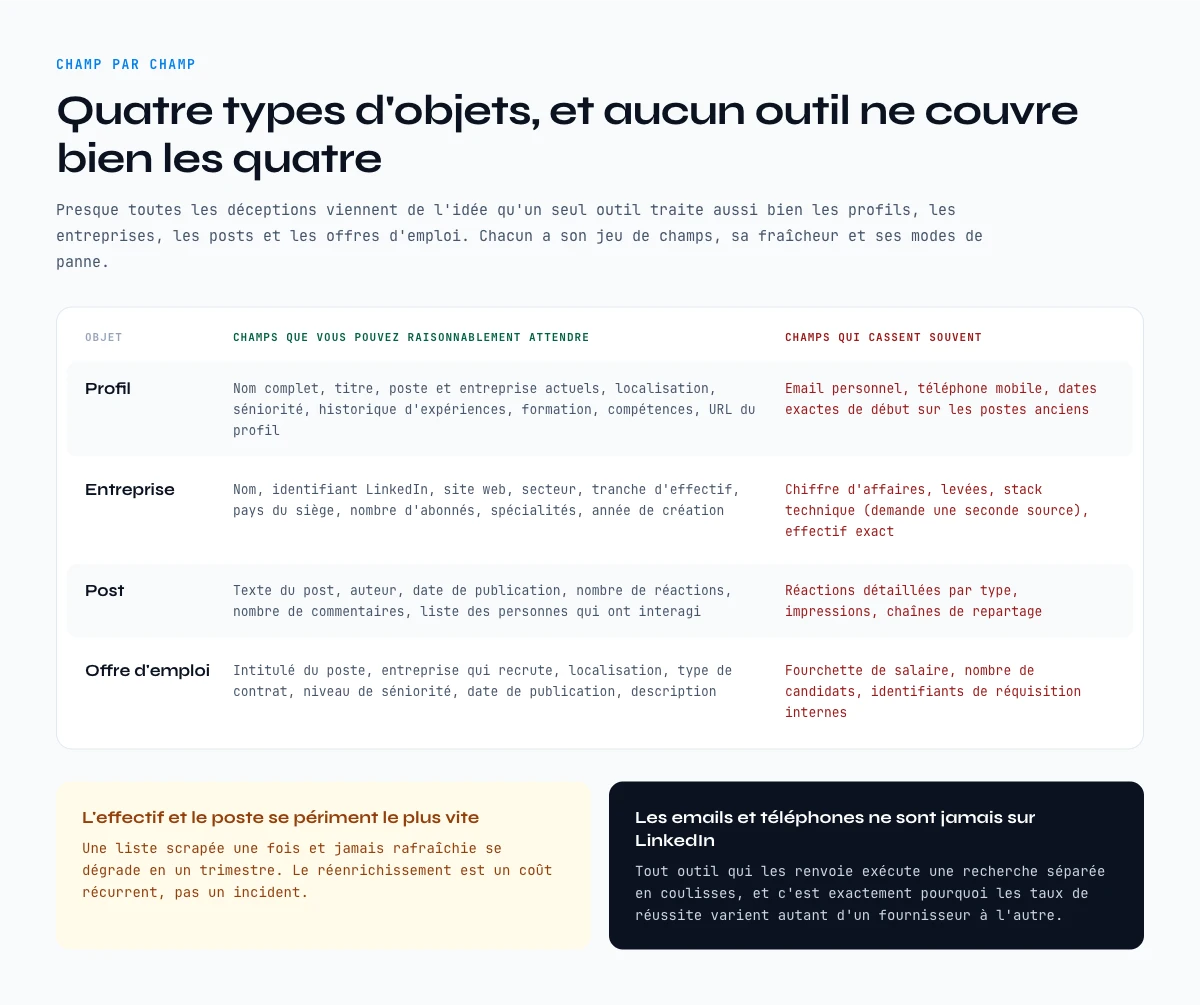
Un scraper LinkedIn rend quatre types d'objets, et la plupart des déceptions viennent du fait qu'on suppose qu'un seul outil couvre les quatre. Profils, entreprises, publications et offres d'emploi ont chacun leur jeu de champs, leur vitesse de péremption et leurs modes de panne.
| Objet | Champs que vous pouvez raisonnablement attendre | Champs qui manquent souvent |
|---|---|---|
| Profil | Nom complet, titre d'accroche, poste actuel, entreprise actuelle, localisation, séniorité, historique d'expériences, formation, compétences, URL du profil | Email personnel, téléphone mobile, dates de début exactes sur les postes anciens |
| Entreprise | Nom, identifiant LinkedIn, site web, secteur, tranche d'effectif, pays du siège, nombre d'abonnés, spécialités, année de création | Chiffre d'affaires, levées de fonds, stack technique (deuxième source nécessaire), effectif exact |
| Publication | Texte du post, auteur, date de publication, nombre de réactions, nombre de commentaires, liste des engageurs | Détail des réactions par type, impressions, chaînes de repartage |
| Offre d'emploi | Intitulé du poste, entreprise, localisation, type de contrat, niveau de séniorité, date de publication, description | Fourchette de salaire, nombre de candidats, identifiants internes |
Deux conséquences à anticiper. D'abord, l'effectif et l'intitulé de poste sont les deux champs qui se périment le plus vite : une liste scrapée une fois et jamais rafraîchie se dégrade en un trimestre. Ensuite, les emails et les téléphones ne sont jamais sur LinkedIn : tout outil qui vous en rend fait tourner une recherche séparée en arrière-plan, ce qui explique des taux de couverture très différents d'un outil à l'autre. Notre comparatif des email finders traite cette seconde étape à part.
Si vous n'avez besoin que d'un champ, de façon répétée, un scrape complet est disproportionné. Les extractions ciblées comme récupérer les infos entreprise depuis une URL de profil coûtent moins cher et cassent beaucoup moins souvent.
Cookie, API ou natif : les trois architectures de scraping LinkedIn
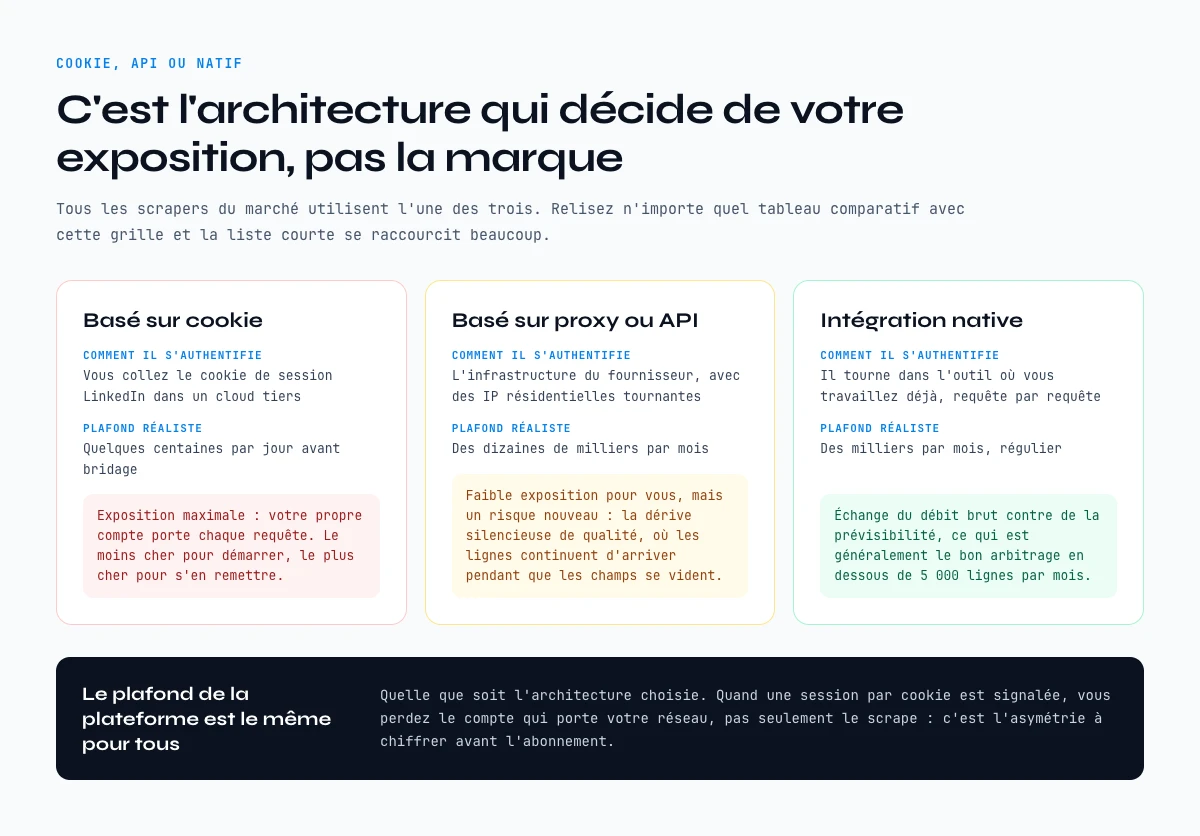
Tous les scrapers LinkedIn du marché reposent sur l'une des trois architectures ci-dessous, et c'est l'architecture qui détermine votre exposition au bannissement, bien plus que la marque. Relisez le comparatif avec cette grille et la liste se réduit vite.
| Architecture | Authentification | Exposition du compte | Ce qui limite le volume | Pour qui |
|---|---|---|---|---|
| Par cookie | Vous collez votre cookie de session LinkedIn dans un cloud tiers | Votre session tourne depuis un cloud tiers, au rythme fixé par l'outil | Les limites de session de LinkedIn | Campagnes ponctuelles, profils no-code |
| Par proxy / API | Infrastructure du fournisseur, IP résidentielles tournantes | Pas liée à votre compte, mais la qualité suit la santé des proxies | L'infrastructure du fournisseur et votre budget | Équipes techniques avec un pipeline |
| Intégration native | Tourne dans l'outil où vous travaillez déjà ; la donnée LinkedIn passe par votre propre session, connectée via une extension | Votre session LinkedIn porte les requêtes, au rythme où vous les lancez | Le rythme que vous choisissez, ligne par ligne | Sales et RevOps qui travaillent dans une app web ou un tableur |
Les outils par cookie sont les moins chers à démarrer et les plus chers à réparer : quand une session est signalée, vous perdez le compte qui porte votre réseau, pas seulement le scrape. Les outils par proxy déplacent ce risque hors de votre compte mais en ajoutent un autre, plus sournois : la dérive silencieuse de qualité, où les lignes continuent d'arriver pendant que les champs se vident. L'intégration native échange du débit brut contre de la prévisibilité : vous voyez chaque ligne arriver et vous décidez du rythme.
Quelle que soit l'architecture, les plafonds côté plateforme sont les mêmes pour tout le monde. Nous avons documenté les chiffres réels dans notre guide des limites de LinkedIn, et la posture de départ la plus sûre est décrite dans le workflow extension Chrome.
Dans l'app web ou Google Sheets
Juger le déroulé, pas la liste de fonctions
La comparaison utile porte sur ce qui se passe après l'extraction. Avec Derrick, les résultats atterrissent dans l'app web ou dans Google Sheets sous forme de lignes et les enrichissements tournent dans le même fichier : aucune étape d'export entre la capture et le travail.
- Fonctionnalité
- Import de leads LinkedIn (classique & Sales Navigator)
- Coût en crédits
- 1 crédit par lead importé
Le premier bouton ouvre l'app web (rien à installer) : 1 crédit par lead importé, 100 crédits offerts chaque mois. Le second détaille la fonctionnalité et son coût par plan.
Meilleur scraper LinkedIn : le top 10 des outils comparés
Il existe aujourd’hui de nombreux outils sur le web pour scraper LinkedIn très facilement. Chacun a son architecture et son terrain de jeu. Voici les dix outils, Derrick en tête.
1- Derrick
Derrick récolte les données de LinkedIn et de Sales Navigator dans son app web, dans Google Sheets, via son API REST ou depuis un assistant IA grâce à son serveur MCP. Il sert à constituer des fichiers clients et à l’enrichissement de base de données. Les fonctionnalités principales :
- L’import de leads : en segmentant vos leads sur Sales Navigator, il est possible de récupérer leurs données en faisant un import dans l'app web ou dans Google Sheets, à 1 crédit par profil.
- L’import de compagnies : le même principe que l’import de leads, appliqué aux pages entreprise.
- L’enrichissement de base de données : Derrick permet d’importer toutes les données présentes sur les profils LinkedIn. Il vous aide à enrichir vos bases de données.
- Retrouver les urls Linkedin d’une entreprise ou d’un lead : à partir du nom d’un lead ou d’une entreprise, Derrick retrouve l’URL de profil.
Les avantages
- Un plan gratuit de 100 crédits par mois, sans carte bancaire, puis un plan Standard à 20 € par mois ;
- Fonctionne dans son app web, sans rien installer, et s’installe aussi directement sur Google Sheet ;
- Facile d’utilisation, il n’est pas nécessaire de savoir coder pour s’en servir ;
- Extraction en temps réel : les données sont lues au moment où vous lancez l’enrichissement, via votre session LinkedIn connectée une fois par l’extension Chrome Derrick, sans cookie à copier à la main ;
- Intégration à plus de 3000 applications pour la synchronisation des données avec vos logiciels de CRM par exemple grâce à l’intégration native de Google Sheet avec Zapier.
Les inconvénients
- Pour la recherche d’email et de téléphone, il faut passer sur un plan payant.
2- Phantombuster
Phantombuster lance des scripts d’automatisation dans le cloud pour extraire des données de LinkedIn (entreprises, profils, membres d’un groupe) et enchaîner des actions de prospection. Il s’appuie sur votre cookie de session LinkedIn, connecté à son cloud. Il couvre aussi d’autres sites comme Facebook, Instagram ou YouTube.
3- Captain Data
Captain Data automatise la récupération de données et construit des workflows de prospection multicanale, avec des espaces de travail partagés entre équipes.
4- Pharow
Pharow récupère des données de prospects selon les personas de votre entreprise, puis exporte la liste vers vos outils de prospection ou de cold mailing.
5- TexAu
TexAu automatise l’extraction de données sur LinkedIn, l’enrichissement de données client et l’envoi d’emails de prospection, à partir de modèles prêts à l’emploi.
6- Evaboot
Evaboot est une extension Chrome centrée sur Sales Navigator : elle exporte les prospects d’une recherche en CSV pour les intégrer dans un CRM.
7- LeadCrush
LeadCrush est une extension Chrome qui exporte des leads et leurs adresses email depuis LinkedIn vers un Google Sheet. Il ne récupère pas les données des entreprises.
8- Dripify
Dripify est une application web d’automatisation qui s’utilise avec LinkedIn et Sales Navigator, et exporte les données des prospects en CSV.
9- Lyne.ai
Lyne.ai est une extension Chrome qui récolte des données de prospects et les synchronise avec des CRM.
10- Wiza
Wiza est une extension Chrome qui exporte les recherches et listes de prospects de Sales Navigator, avec une synchronisation vers des CRM.
L'app traite votre liste ligne par ligne : 1 crédit par lead importé.
Combien coûte vraiment le meilleur scraper LinkedIn chaque mois
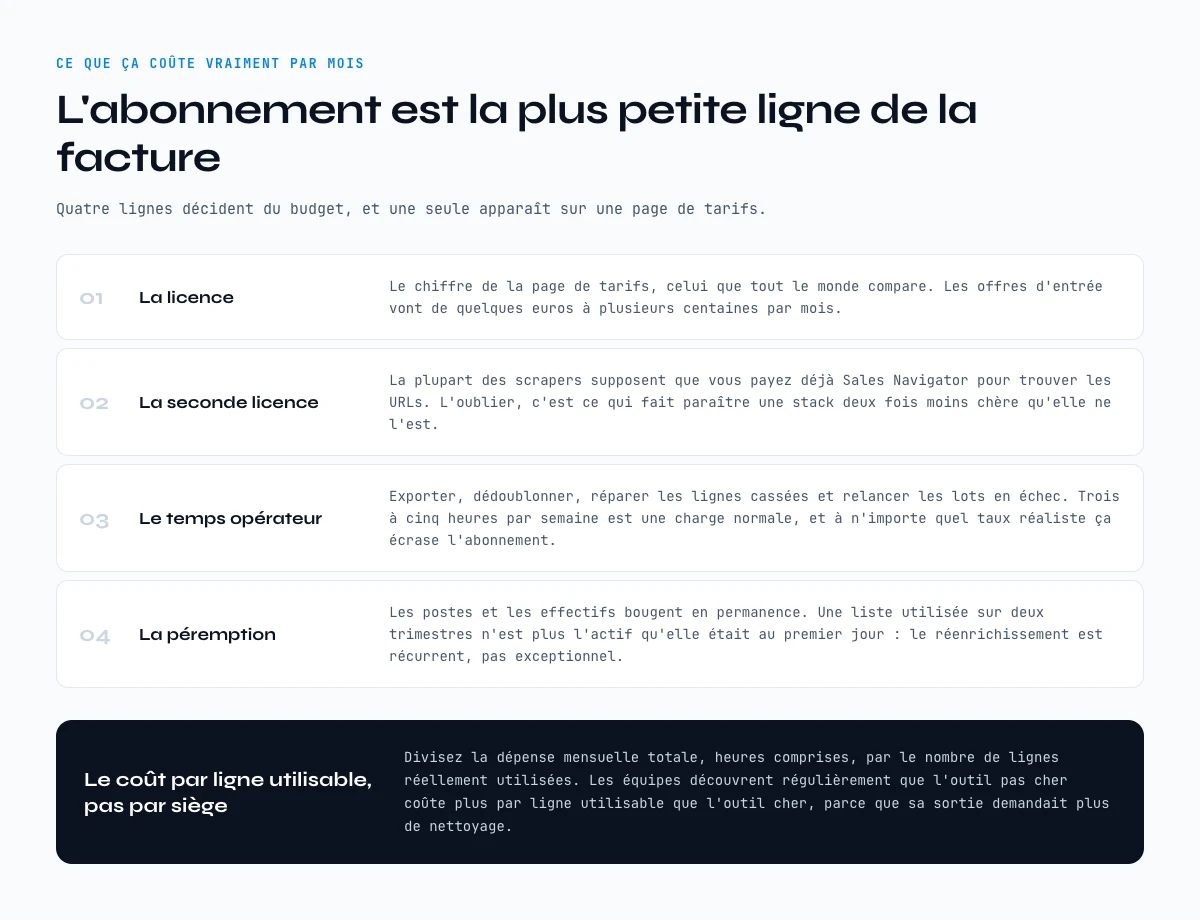
L'abonnement est la plus petite ligne de la facture. Les trois coûts qui décident vraiment de votre budget sont la licence, les heures d'opérateur, et le re-scraping que vous faites parce que la première liste s'est périmée.
- La licence. Les tarifs d'entrée de ce comparatif vont de quelques euros à plusieurs centaines par mois. C'est le chiffre affiché sur la page pricing, et c'est le seul que tout le monde compare.
- La deuxième licence. La plupart des scrapers supposent que vous payez déjà Sales Navigator pour produire les URLs. Budgétez-le : l'oublier, c'est ce qui fait paraître une stack deux fois moins chère qu'elle ne l'est.
- Le temps d'opérateur. Exporter, dédupliquer, réparer les lignes vides et relancer les lots ratés, c'est là que passent les heures. Comptez les heures que votre équipe y passe par semaine : à n'importe quel coût horaire chargé, elles dépassent vite l'abonnement.
- La péremption. Les intitulés de poste et les effectifs bougent en permanence. Une liste scrapée une fois et utilisée deux trimestres n'est plus le même actif qu'au premier jour : le ré-enrichissement est un coût récurrent, pas un incident.
Le test pratique : divisez votre dépense mensuelle totale, heures comprises, par le nombre de lignes réellement utilisées. Les équipes découvrent souvent que l'outil bon marché coûte plus cher par ligne exploitable que l'outil cher, parce que sa sortie demandait plus de nettoyage. C'est aussi l'argument pour garder l'enrichissement là où le nettoyage a déjà lieu, c'est-à-dire dans l'app web ou le tableur.
Le sélecteur plus haut sert de raccourci : il croise votre volume mensuel et votre cas d'usage pour sortir les trois actions qui comptent à votre échelle, et le guide à lire en premier.
Que faire après avoir scrapé LinkedIn
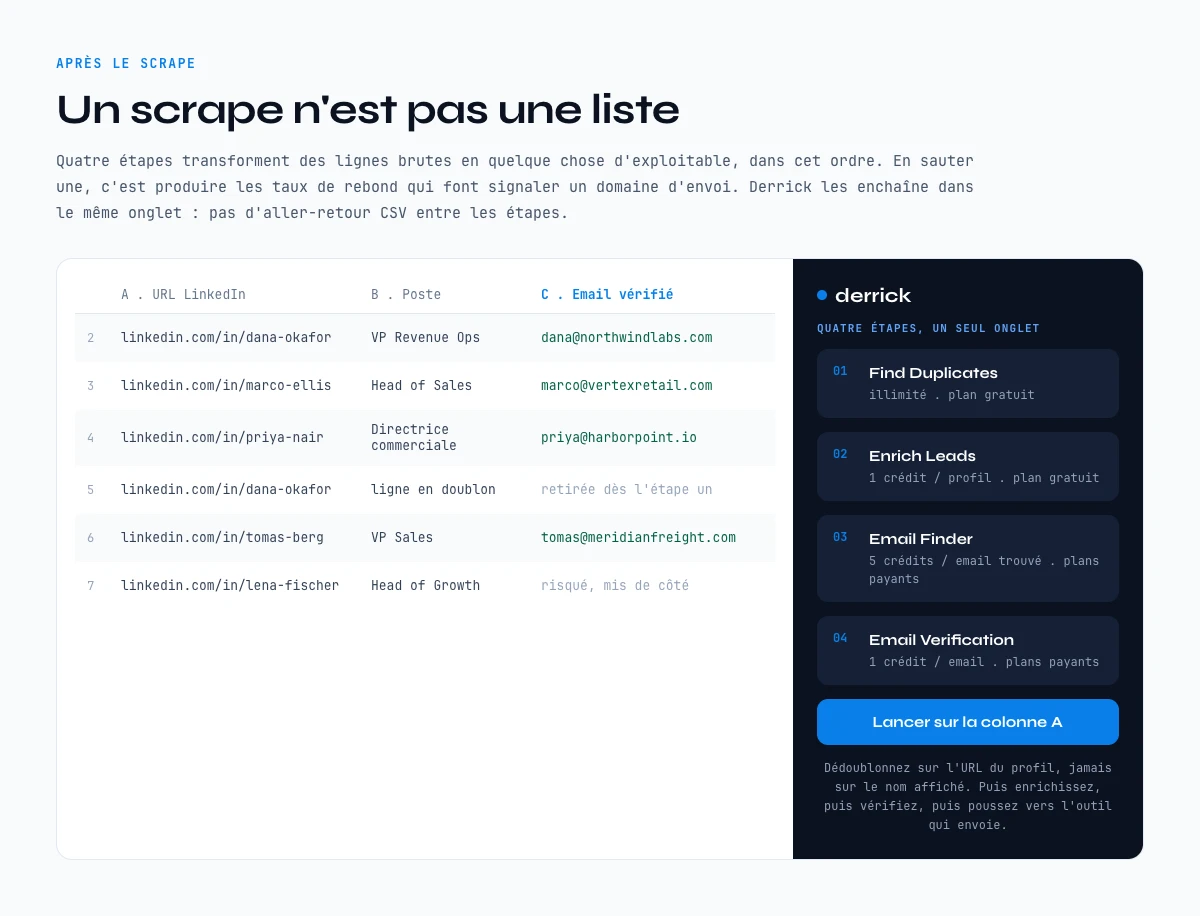
Un scrape n'est pas une liste. Des lignes LinkedIn brutes deviennent exploitables en quatre étapes : dédupliquer, enrichir, vérifier, puis pousser vers l'outil qui envoie. Sauter l'une d'elles, c'est produire les taux de bounce qui font signaler un domaine d'envoi.
- Dédupliquer sur une clé stable. Utilisez l'URL du profil LinkedIn ou l'identifiant entreprise, jamais le nom affiché. La même personne apparaît trois fois sur deux exports plus souvent qu'on ne le croit.
- Enrichir les champs manquants. Emails, téléphones et firmographies viennent d'une seconde recherche, pas du scrape lui-même. Lancez-la sur la liste dédupliquée pour ne pas payer deux fois la même ligne.
- Vérifier avant d'envoyer. Une liste d'emails non vérifiée est un problème de délivrabilité en sursis. La vérification coûte peu face à une réputation de domaine à reconstruire.
- Pousser vers l'outil d'envoi. Enrichir et envoyer sont deux métiers différents. Gardez la liste propre au même endroit, puis exportez-la vers le séquenceur ou le CRM que votre équipe utilise déjà.
C'est là que travailler au même endroit paie : dans l'app web Derrick ou dans un onglet Google Sheets, déduplication, enrichissement et vérification se passent sur la même liste, sans aller-retour CSV entre les étapes. Derrick remplit les colonnes sur place avec Enrich Leads pour la donnée profil et Enrich Companies pour les firmographies, les deux disponibles sur le plan gratuit à 1 crédit par ligne. Notre guide LinkedIn vers Google Sheets déroule le pipeline complet, et le guide de l'API couvre le même flux pour les équipes techniques.
Testez Derrick gratuitement : 100 crédits par mois, sans carte bancaire, et faites tourner ce workflow sur votre propre liste avant de vous engager sur une stack.
Un email tous les 15 jours, sans spam : le formulaire juste sous cet article est là où nous envoyons les nouveaux décryptages sur le scraping LinkedIn.
Scraper de profils ou scraper d'entreprises : lequel il vous faut
Un scraper de profils LinkedIn et un scraper d'entreprises répondent à deux questions différentes, et se tromper de porte est la première raison pour laquelle un projet de scraping s'arrête au bout de deux semaines. Un scraper de profils travaille au niveau de la personne : il lit une URL de profil et vous rend l'individu, son poste actuel, son ancienneté, sa localisation, ses compétences. Un scraper d'entreprises travaille au niveau du compte : il lit une page entreprise et vous rend l'effectif, le secteur, les implantations, les signaux de croissance.
Le test est simple. Si votre prochaine action s'adresse à une personne (un message, un appel, une séquence), il vous faut de la donnée profil. Si votre prochaine action est une décision sur une liste (quels comptes ouvrir, quel segment prioriser, comment découper un territoire), il vous faut de la donnée entreprise. Les équipes qui achètent un scraper de profils pour construire une liste de comptes cibles se retrouvent avec 4 000 lignes d'individus qu'elles ne savent pas regrouper, et celles qui achètent un scraper d'entreprises pour faire de la prospection se retrouvent avec une belle liste de comptes et personne à contacter.
| La question à laquelle vous répondez | Le bon scraper | Champs rendus | Ce que ça alimente |
|---|---|---|---|
| Qui est cette personne et comment la joindre ? | Scraper de profils | Nom, titre du profil, poste actuel, entreprise, ancienneté, localisation, URL, puis email et téléphone sur une recherche à part | Séquences, appels, invitations, fiches contact du CRM |
| Ce compte vaut-il mon temps ? | Scraper d'entreprises | Raison sociale, domaine, tranche d'effectif, secteur, siège, signaux de levée et de recrutement | Découpage de territoire, scoring ICP, listes de comptes, règles d'affectation |
| Qui travaille dans ces 300 comptes ? | Les deux, dans cet ordre | L'entreprise d'abord pour qualifier, puis les profils des comptes qui ont survécu au filtre | De l'outbound par compte où vous ne payez que l'enrichissement de ce qui a passé le filtre |
La troisième ligne est celle qui décide de votre facture. Lancer un scraper de profils sur tous les salariés de tous les comptes de votre liste, c'est la façon la plus sûre de transformer un test de 100 lignes en facture de 9 000 lignes. Qualifiez d'abord au niveau entreprise, gardez les comptes qui correspondent, puis seulement descendez aux personnes. Dans Derrick, ce sont deux étapes distinctes que vous pilotez ligne par ligne : Enrich Companies à 1 crédit par entreprise pour qualifier le compte, puis Enrich Leads à 1 crédit par profil, uniquement sur les rescapés. Les deux sont disponibles sur le plan gratuit, qui embarque 100 crédits par mois : une qualification en deux temps sur une petite liste de test ne vous coûte donc que les crédits réellement dépensés.
Les coordonnées vivent un cran plus loin, et ce n'est pas un hasard si elles ne font pas partie de la donnée profil : trouver un email professionnel vérifié, c'est Email Finder à 5 crédits par email trouvé, et un numéro direct, c'est Phone Finder à 200 crédits par numéro trouvé. Ces deux fonctionnalités sont payantes, elles ne facturent que lorsqu'elles rendent un résultat, et elles sont des étapes séparées précisément pour que vous ne payiez jamais une recherche de coordonnées sur une ligne que vous auriez disqualifiée de toute façon.
Scraper des profils LinkedIn sans maintenir de scraper : tableur, API ou MCP
Ce qui casse dans un scraper de profils LinkedIn, ce n'est presque jamais l'extraction, c'est la maintenance. Les sélecteurs bougent, un parcours de connexion change, un pool de proxies se dégrade, et le script qui marchait en mars rend des chaînes vides en septembre sans lever la moindre erreur. C'est le vrai coût de la voie open source : le code est gratuit, la semaine que vous y passez chaque trimestre ne l'est pas. L'alternative consiste à consommer la donnée profil comme un service, et il y a quatre portes pour ça selon l'endroit où vous travaillez vraiment.
| Où vous travaillez | La surface à utiliser | À quoi ressemble un run | Quand c'est le bon choix |
|---|---|---|---|
| Une liste d'URL de profils dans un tableur | Extension Google Sheets | Vous collez les URL dans une colonne, vous ouvrez la sidebar Derrick, vous choisissez l'enrichissement, les colonnes se remplissent ligne par ligne | Vous vivez déjà dans un tableur et vous voulez le résultat à côté de vos colonnes existantes |
| Une question posée à un assistant IA | Serveur MCP | Vous connectez Derrick à Claude, Claude Code, ChatGPT ou n'importe quel client MCP, puis vous demandez le profil en langage naturel | La recherche est conversationnelle et la réponse alimente un document, pas une base |
| Un pipeline, un CRM ou une application interne | API REST | Un appel authentifié par profil, du JSON structuré en retour, branché sur votre propre file de traitement | L'enrichissement doit se déclencher sur un événement (une inscription, une opportunité, une synchro nocturne) |
| Un navigateur, sans tableur en vue | Application web | Vous importez ou collez une liste, vous lancez les mêmes enrichissements en ligne | La porte d'entrée principale : rien à installer, pour ceux qui ne veulent pas de tableur du tout |
Quelle que soit la porte, la donnée rendue est la même, et ça compte plus qu'il n'y paraît : un profil enrichi depuis la sidebar et un profil enrichi depuis l'API rendent les mêmes champs sous les mêmes noms. Un workflow qui démarre en tableur manuel peut donc devenir un job API planifié sans que personne ne réécrive le mapping. Une recherche sur un profil rend un enregistrement structuré de ce genre :
{
  "linkedin_url": "https://www.linkedin.com/in/exemple-profil/",
  "first_name": "Dana",
  "last_name": "Whitfield",
  "headline": "VP RevOps chez Northwind Logistics",
  "current_title": "VP Revenue Operations",
  "company_name": "Northwind Logistics",
  "company_linkedin": "https://www.linkedin.com/company/northwind-logistics/",
  "location": "Chicago, Illinois, United States",
  "seniority": "VP",
  "tenure_months": 27
}
Deux détails méritent votre attention dans cet enregistrement. Le premier : il ne contient ni email ni téléphone. Ces champs viennent de recherches séparées et payantes, et les tenir hors de la donnée profil est exactement ce qui empêche un run de profils en masse de se transformer en silence en run de coordonnées très cher. Le second : tenure_months, le genre de champ qui décide d'un angle d'approche bien plus sûrement qu'un titre de poste. Quelqu'un qui occupe un poste de VP RevOps depuis 3 mois reconstruit une stack ; quelqu'un qui y est depuis 27 mois défend la sienne. Même intitulé, message opposé.
Si vous hésitez entre la voie open source et une voie gérée, la règle de décision honnête tient en une multiplication : le nombre de profils par mois par ce que vous coûte un champ faux. En dessous de quelques centaines de profils par mois et avec un enjeu faible, un script que vous maintenez est parfaitement raisonnable. Au-dessus, ou dès que la sortie alimente un CRM auquel d'autres personnes font confiance, la maintenance devient le produit. Notre guide du scraping en Python détaille honnêtement la voie du DIY, maintenance comprise, et le guide de l'API de scraping couvre la voie gérée de bout en bout.
LinkedIn scraper : les limites
Scraper LinkedIn fait gagner un temps réel aux équipes marketing et commerciales, mais les conditions d'utilisation de LinkedIn interdisent le scraping automatisé. La plupart des outils ci-dessus passent par une session LinkedIn connectée, et un outil qui pousse trop fort depuis un cloud tiers expose le compte à une restriction. Gardez un rythme proche de celui d'une personne et montez progressivement plutôt que de démarrer à votre volume cible.
Rien de tout cela n'est un conseil juridique : si vous scrapez à grande échelle, parlez-en à un avocat.
Questions fréquentes
Quel est le meilleur LinkedIn scraper gratuit en 2026 ?
Peut-on scraper les résultats de recherche Sales Navigator ?
À quelle vitesse va un scraper LinkedIn ?
Les scrapers LinkedIn trouvent-ils les adresses email ?
LinkedIn va-t-il détecter que j'utilise un scraper ?
Quelles données un scraper LinkedIn ne peut-il pas extraire ?
Combien de profils LinkedIn peut-on scraper par jour sans risque ?
À quelle fréquence re-scraper une liste LinkedIn ?
À lire ensuite
À lire aussi dans ce cocon
Scraper LinkedIn extension Chrome : les 12 meilleurs outils 2026 (workflow, risque, tarifs)
Lire →
Scraper LinkedIn MCP : récupérer les données LinkedIn directement dans Claude (guide 2026)
Lire →
Comment Extraire les Informations d'une Entreprise depuis une URL de Profil LinkedIn : Guide Complet 2026
Lire →
Comment exporter les membres d'un groupe LinkedIn (avec les e-mails) - Tutoriel 2026
Lire →