Métriques de qualité des données : comment les calculer et les suivre
Calculez vos métriques de qualité des données : 11 formules, des exemples chiffrés et un tableau de suivi à copier, sans outil d'observabilité.
Les métriques de qualité des données sont les chiffres qui disent jusqu'où un jeu de données mérite votre confiance pour un usage donné. La plupart des listes qu'on trouve ont été écrites pour des data engineers qui surveillent des tables d'entrepôt et des pipelines. Les formules se transposent pourtant à n'importe quel jeu de données, et elles marchent tout aussi bien sur le fichier qu'un responsable RevOps ou sales ops doit défendre : contacts, comptes, emails et intitulés de poste dans un CRM.
Ce guide vous donne onze métriques de qualité des données, chacune avec sa définition, sa formule et un exemple chiffré. Huit se calculent sur un fichier de contacts, trois sur un journal d'incidents. Vous aurez aussi un tableau de suivi à copier, une façon de mesurer sans acheter d'outil d'observabilité, et le coût de correction de ce que vous aurez trouvé.
Tous les chiffres des exemples sont inventés pour cet article : 200 lignes de contacts B2B, le genre d'export qu'on sort d'un CRM un mardi matin. Cette page définit et calcule. Pour les seuils à respecter au quotidien, voyez notre guide de l'hygiène des données (7 indicateurs et leurs seuils).
Que sont les métriques de qualité des données ?
Une métrique de qualité des données est un calcul reproductible qui transforme une inquiétude floue (« le CRM est un bazar ») en un chiffre qu'on peut suivre dans le temps. Elle a trois composants : une règle qui dit à quoi ressemble une bonne valeur, une population à laquelle elle s'applique, et un ratio ou une durée qui sort des deux.
Prenons « chaque contact doit avoir un intitulé de poste ». La règle : le champ n'est pas vide. La population : les lignes de contacts que vous comptez utiliser. Le résultat : un pourcentage. Refaites le même calcul le mois suivant sur la même population et vous pouvez dire si la situation s'améliore.
Deux propriétés séparent une métrique utile d'une métrique décorative. Elle doit être reproductible : deux personnes qui la calculent sur le même fichier obtiennent le même chiffre. Et elle doit être reliée à une décision : si le chiffre baisse, quelqu'un sait ce qu'il va faire.
Pourquoi suivre ces chiffres ?
Suivre des métriques de qualité des données transforme des symptômes, comme un faible taux de réponse ou un reporting contesté, en une cause mesurée avec sa correction, et prouve qu'un nettoyage a marché. Personne ne reçoit de notification quand une liste perd en exactitude. Ce que vous voyez, ce sont des symptômes qui ressemblent à d'autres problèmes : une campagne au faible taux de réponse, un commercial qui dit que les leads sont mauvais, un reporting par territoire auquel personne ne croit. Sans métriques de qualité des données, chacun de ces sujets devient un débat d'opinions.
Une mesure met fin à ce débat et indique la bonne correction. Une équipe avec 5 % de doublons et une équipe avec 30 % de fiches périmées disent toutes les deux « nos données sont mauvaises », alors que l'une doit fusionner et l'autre rafraîchir. Les métriques permettent aussi de prouver qu'un nettoyage a marché, et c'est souvent ce qu'il faut pour obtenir le budget du suivant.
Métriques de qualité des données et dimensions : quelle différence ?
Une dimension est la qualité qui vous intéresse, exprimée avec des mots : exactitude, complétude, fraîcheur. Une métrique est la façon de mettre un chiffre sur cette qualité dans votre contexte. Les deux mots s'emploient comme des synonymes, et c'est la source de la plupart des confusions sur ce sujet.
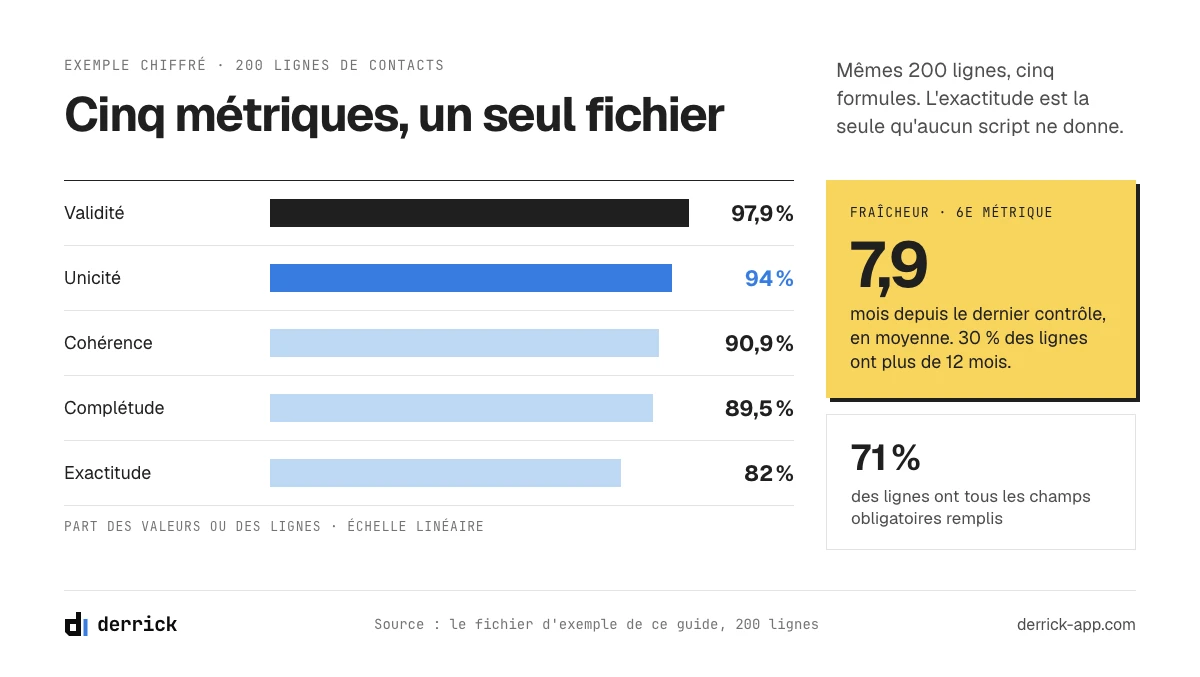
Une même dimension peut produire plusieurs métriques. La complétude peut être la part de cellules remplies parmi les champs obligatoires, la part de lignes dont tous les champs obligatoires sont remplis, ou la part de comptes avec au moins un contact joignable. Les trois sont légitimes, et elles donnent des réponses différentes sur le même fichier. Notre fichier d'exemple obtient 89,5 % sur la première et 71 % sur la deuxième (142 lignes sur 200), car un seul trou disqualifie toute la ligne.
Voilà pourquoi il faut écrire la définition avant de publier un score. « La complétude est à 90 % » ne veut rien dire pour un collègue tant qu'il ne sait pas laquelle des trois vous avez calculée. Les six dimensions ci-dessous sont celles que vous croiserez le plus souvent, et notre guide de la gestion de la qualité des données montre comment elles s'intègrent dans une démarche plus large.
Les six métriques essentielles de qualité des données, avec leur formule
Les exemples de cette section et des métriques 7 et 8 utilisent le même fichier inventé : 200 lignes et quatre champs obligatoires (email, intitulé de poste, domaine de l'entreprise, pays), soit 800 cellules attendues. Les formules restent les mêmes sur une table d'entrepôt : la complétude y devient le taux de valeurs nulles d'une colonne, la fraîcheur le retard depuis le dernier chargement.
1. Taux de complétude
Le taux de complétude est la part des valeurs obligatoires effectivement présentes.
Formule : cellules obligatoires remplies / cellules obligatoires attendues.
Exemple : 716 cellules sur 800 sont remplies, la complétude est donc de 89,5 %. Regardez les trous champ par champ avant de réagir : 84 cellules vides bien réparties et 84 intitulés de poste manquants n'appellent pas du tout le même plan. Ne comptez que les champs que votre processus utilise vraiment. Ajouter une colonne « fax » optionnelle ferait baisser le score sans rien vous apprendre.
2. Taux de validité
Le taux de validité est la part des valeurs remplies qui respectent le format attendu.
Formule : valeurs remplies qui respectent une règle de format / valeurs remplies.
Exemple : 701 des 716 valeurs remplies passent, la validité est donc de 97,9 %. Les 15 échecs sont du type « France » dans une colonne pays à deux lettres, ou un domaine saisi avec « https:// » devant. La validité est la métrique la moins chère que vous calculerez jamais, puisqu'une expression régulière suffit. En revanche, elle ne prouve pas grand-chose à elle seule : un email bien formé peut appartenir à quelqu'un parti en 2023.
3. Taux d'exactitude
Le taux d'exactitude est la part des valeurs contrôlées qui correspondent à la réalité.
Formule : valeurs confirmées correctes par une source fiable / valeurs contrôlées.
Exemple : vous contrôlez 50 fiches à la main, en les comparant au profil actuel de la personne et au site de l'entreprise, et 41 ont le bon poste dans la bonne entreprise. Soit 82 %. Aucun script ne peut vous donner ce chiffre : une machine dit si une valeur a l'air juste, alors que l'exactitude demande si elle l'est. Sur 50 fiches, la marge d'erreur à 95 % de confiance est d'environ 11 points dans les deux sens, annoncez donc « entre 71 et 93 % environ » tant que vous n'en avez pas contrôlé davantage. Pour la méthode champ par champ, voyez notre guide sur ce que veut dire l'exactitude sur une liste de contacts.
4. Taux de cohérence
Le taux de cohérence est la part des fiches dont les champs liés ne se contredisent pas.
Formule : fiches dont les champs liés concordent / fiches où les deux champs existent.
Exemple : 164 lignes ont à la fois un email et un domaine d'entreprise. Dans 149 d'entre elles, le domaine de l'email correspond au domaine de l'entreprise, soit 90,9 %. Les 15 autres méritent d'être ouvertes : certaines sont sans gravité (le domaine email d'une maison mère), d'autres sont des personnes qui ont changé de poste et dont le fichier garde une ancienne adresse. Autres paires à tester : le pays et l'indicatif téléphonique, le nom de l'entreprise et le domaine. La cohérence est souvent la première métrique à repérer une fiche périmée, car un changement de poste casse le lien entre deux champs bien avant que quelqu'un mette l'un des deux à jour.
5. Taux d'unicité
Le taux d'unicité indique à quel point le fichier s'approche d'une ligne par personne ou par entreprise réelle.
Formule : personnes distinctes / lignes de contacts au niveau contact ; domaines distincts / noms d'entreprise distincts au niveau compte.
Exemple : commencez par les contacts. Les 200 lignes contiennent 188 personnes distinctes, l'unicité est donc de 94 %. Recommencez ensuite au niveau des comptes, là où la plupart des équipes ne regardent jamais. Le fichier affiche 143 noms d'entreprise distincts, mais 131 domaines distincts seulement : 12 noms sont des variantes d'une entreprise déjà présente (« Acme », « Acme Inc », « ACME SAS »). L'unicité des comptes vaut 131 / 143, soit 91,6 %. À cause de cet écart, deux commerciaux peuvent travailler la même entreprise pendant des semaines.
6. Fraîcheur
La fraîcheur, ou actualité, indique depuis quand une fiche n'a pas été confirmée. Deux chiffres la décrivent.
Formules : nombre moyen de mois depuis la dernière vérification ou le dernier enrichissement de chaque fiche ; fiches au-delà de votre limite d'âge / total des fiches.
Exemple : 60 lignes ont été traitées il y a environ 2 mois, 80 il y a environ 7 mois et 60 il y a environ 15 mois. L'âge moyen est de 1 580 / 200, soit 7,9 mois, et 30 % des lignes ont plus de 12 mois. Mesurez depuis la dernière vraie vérification, pas depuis la dernière modification : une automatisation du CRM qui réécrit un champ remet à zéro la date de modification sans rien contrôler. Notre guide sur la fraîcheur des données B2B explique pourquoi le bon âge varie selon le champ.
Dans l'app web ou Google Sheets
Mesurer votre taux d'emails valides sur un vrai échantillon
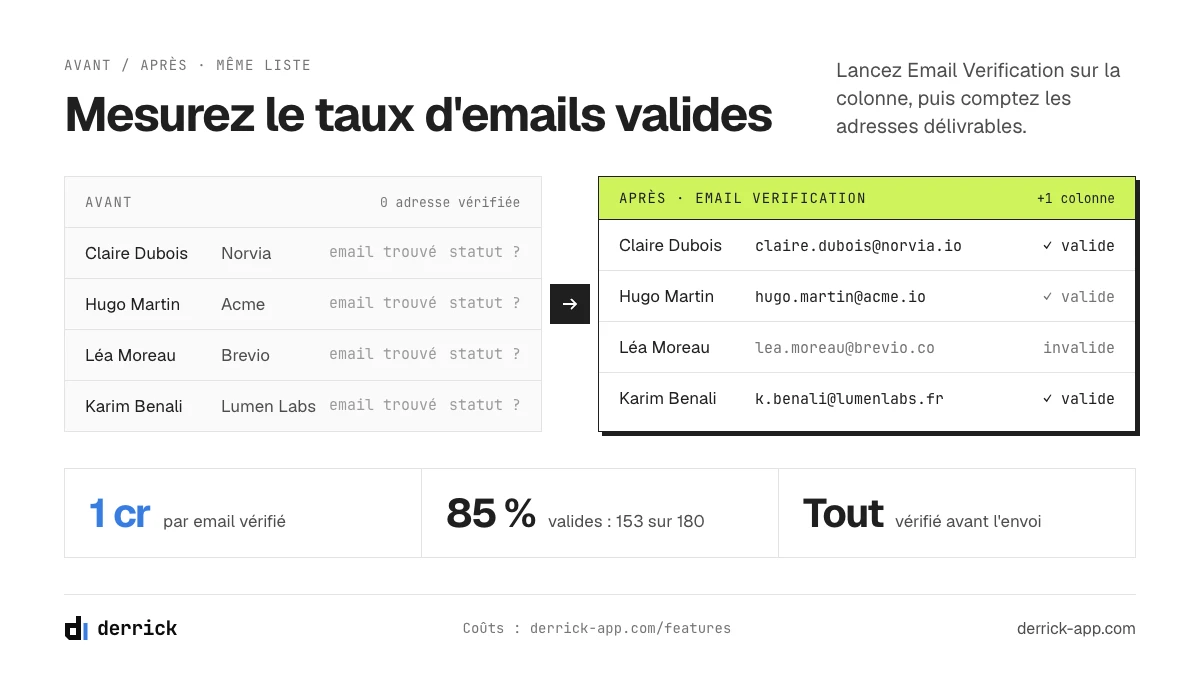
Parmi les métriques de cette page, le taux d'emails valides est celle qu'on ne calcule pas à la main. Importez votre échantillon en CSV dans l'app web Derrick, lancez la vérification sur la colonne des emails, et chaque adresse revient avec un statut à compter pour votre tableau de suivi.
- Fonctionnalité
- Vérification d'email
- Coût en crédits
- 1 crédit par vérification
Le premier bouton ouvre l'app web (rien à installer) : 1 crédit par vérification, disponible dès le plan STANDARD. Le second détaille la fonctionnalité et son coût par plan.
Les métriques avancées de qualité des données : emails, couverture et délais
Les six métriques essentielles décrivent l'état d'un fichier. Ces cinq-là décrivent ce qui se passe quand vous l'utilisez, et la vitesse de réaction de votre équipe face à un problème. Les deux premières s'appuient sur le même fichier d'exemple. Les trois dernières se calculent à partir d'un journal d'incidents : leur exemple est donc un autre scénario, inventé lui aussi.
7. Taux d'emails valides
Le taux d'emails valides est la part des adresses testées qu'une vérification confirme comme délivrables.
Formule : adresses vérifiées comme délivrables / adresses testées.
Exemple : 180 lignes ont un email. La vérification en confirme 153, le taux d'emails valides est donc de 85 %. Les 27 autres se répartissent entre 18 adresses à risque et 9 adresses mortes. Ce taux diffère du taux de rebond, que vous n'apprenez qu'après l'envoi, une fois que votre réputation d'expéditeur a payé. La vérification vous en donne une bonne estimation avant l'envoi, et vous décidez du sort des adresses à risque.
8. Taux de couverture
Le taux de couverture est la part des cellules vides qu'un enrichissement parvient à remplir.
Formule : cellules vides remplies par un enrichissement / cellules vides soumises.
Exemple : vous soumettez les 84 cellules vides et 52 reviennent remplies, la couverture est donc de 61,9 %. Ne lisez jamais ce chiffre seul. Un fournisseur peut gonfler sa couverture en renvoyant des correspondances faibles, ce qui fait ensuite baisser l'exactitude sur les lignes que vous pensiez avoir corrigées. Notre page sur la couverture face à l'exactitude montre comment tester les deux ensemble.
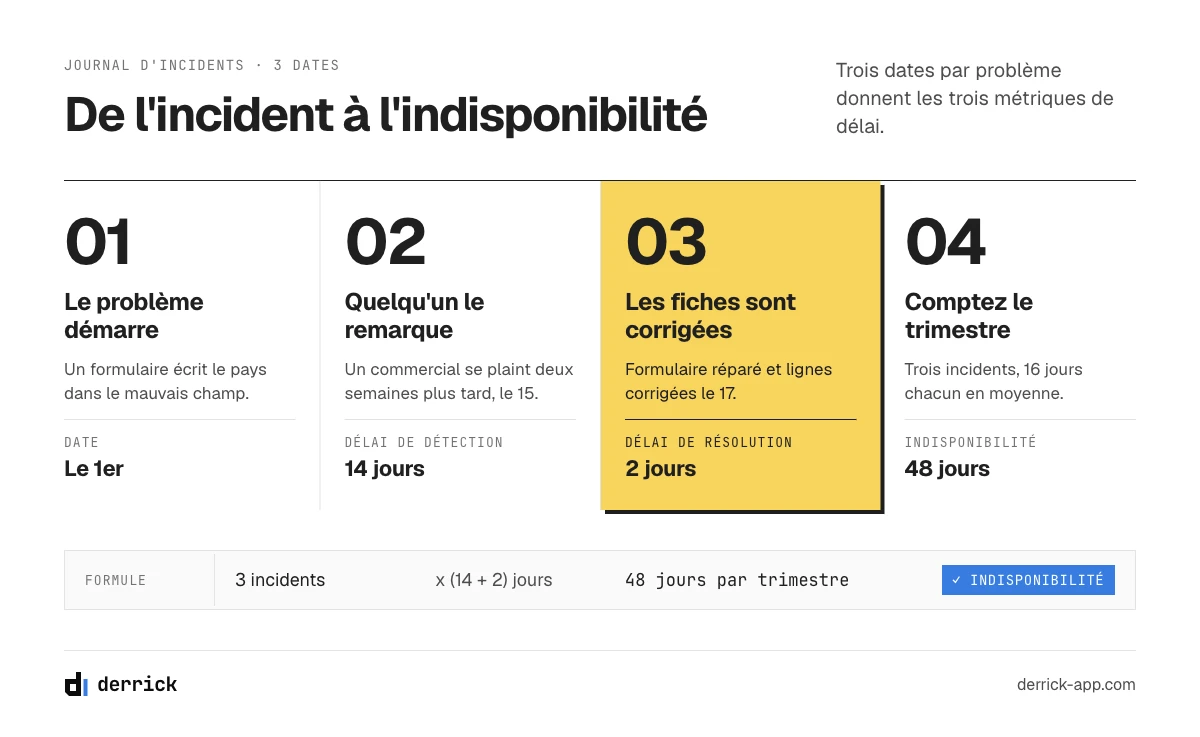
9. Délai de détection
Le délai de détection est le temps pendant lequel un problème de données passe inaperçu.
Formule : date à laquelle le problème a été remarqué moins date de son début.
Exemple : le 1er, une modification de formulaire envoie le pays dans le mauvais champ. Un commercial s'en plaint le 15. Le délai de détection est de 14 jours, et il restera aussi long tant que l'alerte viendra d'un commercial. Un contrôle de validité une fois par semaine l'aurait plafonné à sept jours.
10. Délai de résolution
Le délai de résolution est le temps pendant lequel le dégât reste dans la base une fois repéré.
Formule : date de correction des fiches touchées moins date à laquelle le problème a été remarqué.
Exemple : le formulaire est réparé et les mauvaises lignes corrigées le 17, le délai de résolution est donc de 2 jours. La date de clôture est celle où les fiches sont corrigées, pas celle où le ticket est fermé. Beaucoup d'équipes corrigent la cause et laissent les lignes abîmées dans la base.
11. Indisponibilité des données
L'indisponibilité des données (data downtime) est la durée totale pendant laquelle une partie de vos données n'était pas fiable.
Formule : nombre d'incidents x (délai moyen de détection + délai moyen de résolution).
Exemple : trois incidents sur un trimestre, à 14 et 2 jours en moyenne, font 3 x 16 = 48 jours. Les dirigeants comprennent ce chiffre tout de suite : « 48 mauvais jours au dernier trimestre » n'a pas besoin qu'on explique ce qu'est la validité.
Comment calculer ces métriques sur un échantillon de 200 lignes
Vous n'avez pas besoin d'une plateforme d'observabilité pour cela. Ces outils se justifient quand on surveille des centaines de tables. Pour un export de CRM, un tableur et une après-midi donnent sept des onze métriques de qualité des données. La couverture viendra avec votre prochain enrichissement, et les trois métriques de durée avec un journal que vous ouvrez dès aujourd'hui.
- Tirez un échantillon au hasard. Exportez 200 lignes au hasard dans le segment que vous utilisez vraiment, par exemple les prospects actifs. Évitez les 200 premières par date de création, qui surreprésentent les vieilles fiches. Sur 200 lignes et à 95 % de confiance, un pourcentage a une marge de 7 points au plus dans les deux sens, et moins pour les taux proches de 100 %. C'est assez pour voir un vrai problème.
- Écrivez la liste des champs obligatoires. Choisissez-les d'après ce dont vos séquences et vos règles de routage ont besoin. Quatre à six, c'est normal.
- Comptez les vides et appliquez les règles de format. Vous avez la complétude et la validité en quelques minutes.
- Cherchez les doublons. Dans Google Sheets, la fonction Find Duplicates signale gratuitement les lignes répétées depuis le panneau latéral. Lancez-la sur l'email, puis sur le domaine pour la vue par compte. C'est la seule étape Derrick de cette liste qui demande Google Sheets ; la vérification des emails (étape 5) se fait dans l'app web Derrick.
- Vérifiez les emails. Importez l'échantillon en CSV dans l'app web Derrick et lancez Email Verification sur la colonne. Il faut un plan payant (à partir de STANDARD, 20 € par mois) et cela coûte 1 crédit par email contrôlé : 180 x 1 crédit pour notre fichier, 200 x 1 crédit au plus pour un échantillon complet de 200 lignes. Chaque adresse testée est facturée, invalides comprises.
- Testez les champs liés. Ajoutez une colonne qui extrait le domaine de l'email, puis comparez-la au domaine de l'entreprise.
- Contrôlez 50 fiches à la main. Comptez environ deux minutes par fiche, soit un peu moins de deux heures. C'est la seule étape qui donne une vraie exactitude, ne la sautez pas.
- Relevez l'âge de chaque fiche. Partez de la date de dernière vérification ou de dernier enrichissement, puis calculez la moyenne et la part au-delà de votre limite.
- Ouvrez un journal d'incidents. Trois dates par problème suffisent : début, repérage, correction. Vos métriques de durée et l'indisponibilité des données en sortent.
Le tuto ci-dessous montre l'étape 5, la vérification des emails, de l'import à la liste triée.
L'app traite votre liste ligne par ligne : 1 crédit par vérification.
Un tableau de suivi des métriques de qualité des données à copier
Rassemblez les résultats dans un seul tableau et gardez-le au même endroit chaque mois. Les cibles marquées « point de départ » sont nos suggestions pour les métriques sans seuil standard : ajustez-les après deux ou trois relevés. Quand une ligne indique « seuil d'hygiène », reportez-vous aux chiffres de notre guide de l'hygiène des données : ils s'appliquent à la complétude par ligne, à la part de fiches périmées et aux autres contrôles de routine. Une seule série de chiffres évite deux verdicts sur le même fichier.
Pour situer votre première mesure par rapport à d'autres fichiers, nos benchmarks de qualité des données B2B donnent des chiffres de référence champ par champ.
| Métrique | Formule | Échantillon | Cible | Responsable, contrôle |
|---|---|---|---|---|
| Complétude | Cellules remplies / attendues ; lignes complètes / lignes | 89,5 % ; 71 % des lignes | Seuil d'hygiène, par ligne | RevOps, une fois par mois |
| Validité | Conformes / remplies | 97,9 % | Seuil d'hygiène | RevOps, une fois par semaine |
| Exactitude | Confirmées / contrôlées | 82 % | 85 %, point de départ | Sales ops, une fois par trimestre |
| Cohérence | Concordantes / deux champs présents | 90,9 % | 95 %, point de départ | RevOps, une fois par mois |
| Unicité, contacts | Distincts / lignes | 94 % | Seuil d'hygiène | RevOps, une fois par mois |
| Unicité, comptes | Domaines / noms d'entreprise | 91,6 % | 97 %, point de départ | RevOps, une fois par mois |
| Fraîcheur | Âge moyen ; part au-delà de la limite | 7,9 mois ; 30 % | Moins de 20 % au-delà de la limite, point de départ | Marketing ops, une fois par mois |
| Emails valides | Délivrables / testés | 85 % | 90 %, point de départ | Marketing ops, avant chaque envoi |
| Couverture | Remplies / soumises | 61,9 % | Seuil d'hygiène | RevOps, à chaque enrichissement |
| Délai de détection | Remarqué moins début | 14 jours | Moins de 7 jours, point de départ | Propriétaire de la donnée, par incident |
| Délai de résolution | Corrigé moins remarqué | 2 jours | Moins de 5 jours, point de départ | Propriétaire de la donnée, par incident |
| Indisponibilité des données | Incidents x (détection + résolution) | 48 jours par trimestre | En baisse chaque trimestre, point de départ | Propriétaire de la donnée, une fois par trimestre |
S'il vous faut un seul chiffre, pondérez les pourcentages selon ce qu'ils vous coûtent quand ils dérapent. Pour une équipe de prospection, nous prendrions exactitude 30 %, emails valides 20 %, complétude 20 %, puis 10 % chacun pour l'unicité, la cohérence et la validité. Sur notre exemple, avec la complétude par cellule et l'unicité des contacts :
(82 x 0,3) + (85 x 0,2) + (89,5 x 0,2) + (94 x 0,1) + (90,9 x 0,1) + (97,9 x 0,1) = 87,8, soit environ 88 sur 100. Avec une exactitude mesurée sur 50 fiches, ce score peut bouger d'environ 3 points dans les deux sens. Regardez ce qu'il cache : seules 71 % des lignes sont complètes, un niveau que le guide de l'hygiène des données classe comme bloquant, et le score global reste pourtant rassurant.
Ce score composite n'est qu'un résumé. Il peut rester stable alors que l'exactitude baisse et que la validité monte : gardez donc le tableau en dessous. La fraîcheur et les délais restent à l'écart, car des mois et des jours ne se moyennent pas avec des pourcentages, et la couverture aussi, car elle juge un enrichissement et pas le fichier.
KPI de qualité des données : ce qu'il faut remonter
La différence entre une métrique et un KPI, c'est le public. Vous pouvez suivre onze métriques de qualité des données dans votre revue opérationnelle. La direction en a besoin de trois au maximum, chacune reliée à un sujet qui la préoccupe déjà.
- Le taux d'emails valides, parce qu'il protège la délivrabilité de chaque campagne.
- L'exactitude sur le segment actif, parce qu'elle fixe le temps qu'un commercial perd avec la mauvaise personne.
- L'indisponibilité des données, parce qu'elle compte les jours où l'équipe a travaillé sur des données peu fiables.
Présentez la tendance par rapport au trimestre précédent et nommez la correction que vous avez financée. Une phrase comme « les emails valides sont passés de 85 à 93 % depuis que nous vérifions avant chaque envoi » (notre exemple, pas une référence du marché) parle à un directeur financier.
Mettre en place vos métriques de qualité des données : base de départ, responsables, fréquence, alertes
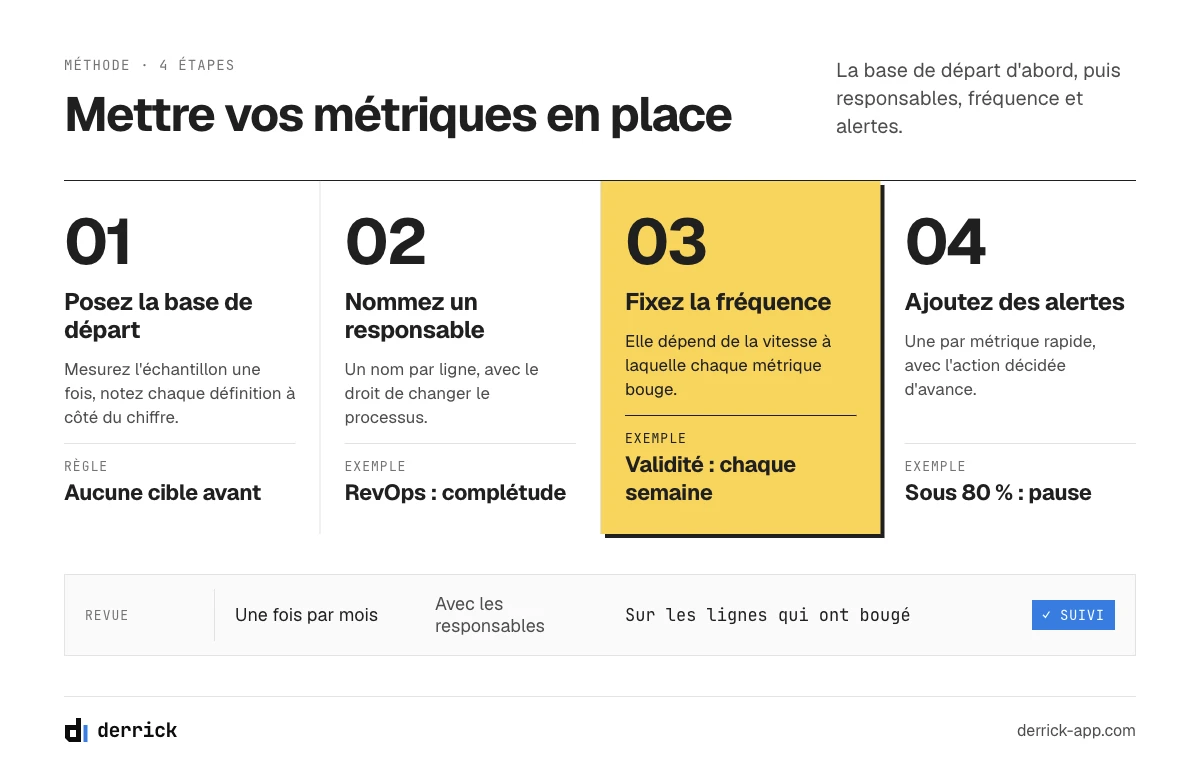
Commencez par une base de départ : mesurez l'échantillon une fois, écrivez chaque définition à côté de son chiffre, et ne fixez aucune cible avant ce premier relevé. Automatisez ensuite, en commençant par les règles de format, les moins chères à faire tourner.
Fixez alors la fréquence, qui dépend de la vitesse à laquelle chaque métrique peut bouger et du coût d'un mauvais relevé. Les erreurs de format peuvent arriver du jour au lendemain à cause d'un seul formulaire cassé : la validité mérite donc un contrôle une fois par semaine, automatisé si possible. L'exactitude coûte des heures de travail humain et dérive lentement : une fois par trimestre suffit en général. Le taux d'emails valides se mesure juste avant chaque campagne, puisque c'est là qu'il rapporte.
Chaque ligne du tableau a besoin d'un nom, et cette personne doit pouvoir changer le processus qui crée le problème. Une répartition courante : RevOps suit les métriques structurelles comme la complétude, la validité et l'unicité. L'équipe marketing ops s'occupe de ce qui touche à l'envoi. L'équipe sales ops, ou un chef d'équipe, se charge du contrôle d'exactitude, car les commerciaux en subissent les effets en premier.
Enfin, fixez une alerte pour chaque métrique qui peut bouger vite, et décidez à l'avance de ce qui se passe à chaque niveau. Par exemple, sur le taux d'emails valides : sous 90 %, quelqu'un relit la liste ; sous 80 %, la séquence s'arrête jusqu'à ce que la liste soit revérifiée. Ces deux chiffres sont des points de départ à ajuster. Passez le tableau en revue une fois par mois avec les responsables, et concentrez-vous sur les lignes qui ont bougé.
Cinq pièges dans la lecture de ces chiffres
- Mesurer toute la base plutôt que le segment utilisé. Un fichier de 100 000 lignes avec 20 000 fiches dormantes peut sembler catastrophique alors que vos prospects actifs vont bien, ou l'inverse. Mesurez les fiches que vous contactez vraiment.
- Faire d'une métrique un objectif. Si vous récompensez la couverture, les gens accepteront des correspondances faibles. Associez la couverture à l'exactitude pour que l'une ne monte pas au détriment de l'autre.
- Changer la définition sans le dire. Ajoutez un champ obligatoire en mars et la complétude baisse en mars, sans que les données aient changé. Notez chaque changement de définition à côté du score.
- Prendre un score de confiance pour de l'exactitude. Le score de confiance d'un fournisseur prédit la probabilité qu'une valeur soit juste : il ne remplace donc pas le contrôle manuel d'un échantillon.
- S'arrêter au score. Décidez avant de commencer quelle correction chaque métrique déclenche : fusionner, normaliser, vérifier, enrichir ou recontrôler.
Ce que coûte chaque correction
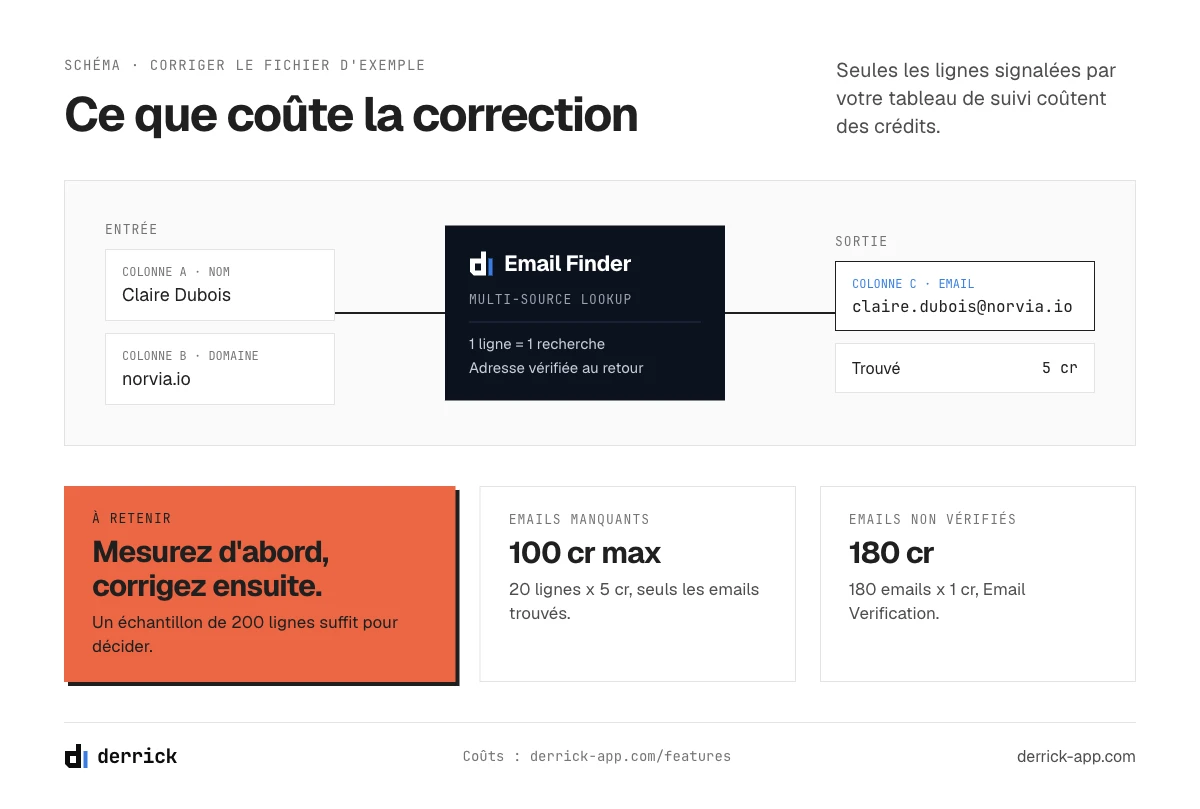
Sur l'exemple de 200 lignes, la correction complète revient à 180 x 1 crédit pour la vérification, au plus 20 x 5 crédits pour les emails manquants et 60 x 1 crédit pour les intitulés périmés, plus environ trois heures de travail manuel. Voici ce qu'implique la correction des problèmes du fichier d'exemple, et comment le même travail passe à 10 000 lignes. Ce tableau sert généralement de base à la demande de budget.
| Problème | Action | Sur 200 lignes | Sur 10 000 lignes |
|---|---|---|---|
| Doublons | Find Duplicates dans Google Sheets, puis fusion | Gratuit, environ 30 minutes de fusion | Gratuit, la fusion dépend du taux trouvé |
| Erreurs de format | Normaliser avec une règle à l'entrée | Environ 15 minutes | Une règle, le même travail |
| Emails non vérifiés | Email Verification, 1 crédit par email | 180 x 1 crédit | Jusqu'à 10 000 crédits, l'allocation mensuelle du plan STANDARD à 20 € |
| Emails manquants | Email Finder (plans payants, à partir de STANDARD à 20 €), qui vérifie déjà l'adresse qu'il renvoie | Au plus 20 x 5 crédits, pour les 20 lignes sans email ; seuls les emails trouvés sont facturés | 10 % de lignes vides feraient au plus 1 000 x 5 crédits |
| Champs entreprise manquants | Enrich Companies, avec votre compte LinkedIn connecté via l'extension Chrome, disponible dès le plan FREE | 1 crédit par entreprise à compléter | Le même tarif par entreprise |
| Mauvais intitulés | Enrich Leads sur les fiches au-delà de votre limite d'âge, avec LinkedIn connecté, disponible dès le plan FREE | 60 x 1 crédit, pour les 60 lignes de plus de 12 mois | 30 % de lignes feraient 3 000 x 1 crédit |
| Prouver la correction | Nouveau contrôle manuel d'un échantillon | 50 fiches, environ 2 heures | Les mêmes 50 fiches : l'échantillon ne grandit pas avec le fichier |
La dernière ligne surprend souvent. La taille d'un échantillon fiable dépend très peu de la taille de la base : 200 lignes vous en apprennent presque autant sur un fichier de 10 000 que sur un fichier de 100 000. Mesurer reste bon marché à tout volume, alors que corriger grandit avec le fichier. Mesurez donc d'abord, puis dépensez sur le segment qui rapporte.
À retenir
Écrivez la définition à côté de chaque chiffre, sinon la comparaison du mois suivant ne vaudra rien.
Commencez par les six métriques essentielles de qualité des données, puis ajoutez le taux d'emails valides, la couverture et les délais une fois le premier tableau en place. Un échantillon aléatoire de 200 lignes et un tableur suffisent pour démarrer. Les 50 contrôles manuels demandent le plus d'effort, et ce sont les seuls à mesurer directement l'exactitude.
Enfin, donnez à chaque ligne un responsable et décidez de ce qui se passe le jour où elle baisse. Une fois votre premier relevé fait, la boucle de nettoyage des données B2B est la lecture suivante logique.
Questions fréquentes
Quelles sont les principales métriques de qualité des données ?
Quelle différence entre métriques de qualité des données et dimensions ?
Comment calculer ces métriques sur un fichier de contacts ?
Qu'est-ce que l'indisponibilité des données ?
Quelle taille doit faire un échantillon de contrôle ?
Quels KPI de qualité des données présenter à la direction ?
À quelle fréquence mesurer les métriques de qualité des données ?
Faut-il un outil d'observabilité pour suivre la qualité des données ?
À lire ensuite
À lire aussi dans ce cocon
Benchmark de péremption des données B2B 2026 : vitesse, types et cadence
Lire →
Comment mesurer la qualité de vos données enrichies : le guide complet
Lire →
Data Freshness : à quelle fréquence rafraîchir vos données B2B ?
Lire →
Taux de couverture vs taux de précision : comprendre les métriques de l'enrichissement B2B
Lire →